マシンビジョンにおける基本的な要件の1つは、カラー成分を異なる画像に分離することです。 これには、例えばRGBをそれぞれの成分に分離することのほか、HSLやXYZなどの分離も含まれます。 以下に、カラー分離のいくつかの例を示します。 すべての例で、入力としてRGBエリアセンサカメラを使用しています。 もちろん、これらの例はラインセンサカメラにも同様に適用できます。 さらに、前段階でのBayer De-Mosaicingや色空間変換も想定され、これらの例に簡単に追加することができます。
これらの例では、ホストPCでの後処理のためにカラー分離が必要であると仮定しています。 したがって、これらの例はカラー分離されたDMA転送に焦点を当てています。 FPGA内でカラー分離されたデータの処理が必要な場合も、お客様の要件に合わせてこれらの例を適用できます。
いくつかの例を示します。 すべての例で得られる結果は同じです。 しかし、実装方法は完全に異なり、それぞれにメリットとデメリットがあります。 お客様の要件に最も適した例を選択する必要があります。 次の表に、すべての例といくつかのPropertyを一覧で示します。
| サンプル名 | レイテンシー | DRAM | Block RAM数 | DMA出力 |
|---|---|---|---|---|
| 3つのDMA | 追加のレイテンシーはありません | 1つのDRAMバッファ | Low | 3つのDMA。各カラー成分に1つずつ。 |
| 3つのバッファを使用するシーケンシャル | レイテンシが理論上の最小値まで最小化されます。 | 3つのDRAMバッファ | Low | 1つのDMA。カラー成分をシーケンシャルに出力。 |
| MultiROIバッファを使用するシーケンシャル | 1フレームのレイテンシと帯域幅の制限。 | 1つのDRAMバッファ | 通常 | 1つのDMA。カラー成分をシーケンシャルに出力。 |
| 事前ソートされたMultiROIバッファを使用するシーケンシャル | 1フレームのレイテンシ | 1つのDRAMバッファ | High | 1つのDMA。カラー成分をシーケンシャルに出力。 |
| 高度なバッファ使用法を使用するシーケンシャル | 1フレームのレイテンシ | 1つのDRAMバッファ | Low | 1つのDMA。カラー成分をシーケンシャルに出力。 |
表 20: カラー分離の例の概要
前の表に示されているPropertyの詳細な説明、およびさまざまな方式の詳細な説明については、 次のセクションで解説します。
| 概要 | |
|---|---|
|
ファイル: \examples\Processing\Color\ColorPlaneSeparation\ColorPlaneSeparation_Option1_ThreeDMA.va |
 |
|
デフォルトプラットフォーム: mE5-MA-VCL |
|
|
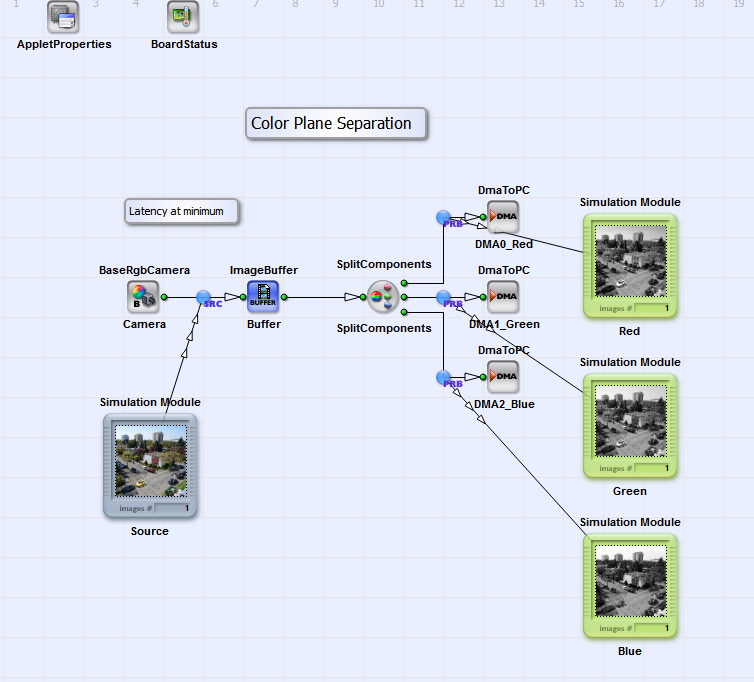
簡単な説明 RGBカラープレーン分離の例。 成分は3つのDMA出力チャネルに分割されます。 |
|
この例は非常にシンプルです。 入力されたRGB画像がバッファリングされ、その後、カラープレーンが3つの出力リンクに分割されます。 これら3つのリンクは、3つの DmaToPC オペレーターを使用してPCに転送されます。 このソリューションの利点は、レイテンシが最小限に抑えられることです。 画像はフレームグラバーでバッファリングされません。 ホストPCの処理速度が十分であれば、ImageBufferオペレーターによる画像の遅延は1ライン分のみとなります。 追加の遅延は発生しません。 もう1つの利点は、必要なDRAMオペレーターが1つだけであることです。
この実装のデメリットは、3つのDMA出力オペレーターが必要になることです。 これらのオペレーターは、フレームグラバーの多くのFPGAロジックリソースを消費します。 それほどレイテンシを最小化する必要がない場合は、次の章で紹介するソリューションのいずれかを検討してください。
| 概要 | |
|---|---|
|
ファイル: \examples\Processing\Color\ColorPlaneSeparation\ColorPlaneSeparation_Option2_ThreeBuffersOneDMA.va |
 |
|
デフォルトプラットフォーム: mE5-MA-VCL |
|
|
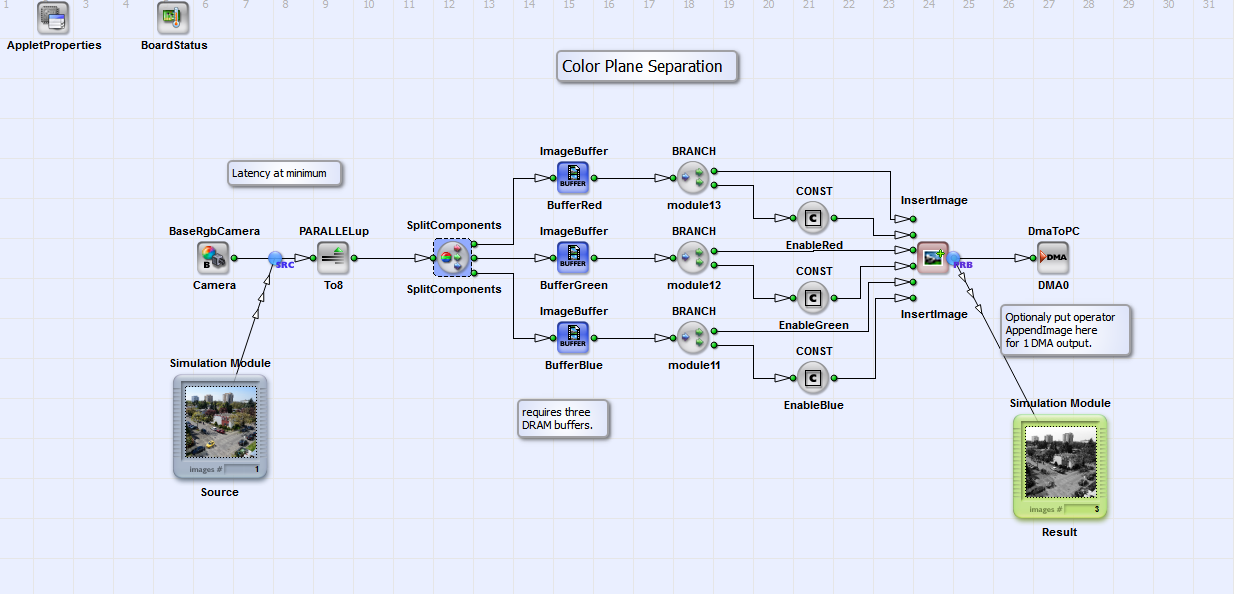
簡単な説明 RGBカラープレーン分離の例。各コンポーネントは分割され、3つのフレームグラバーバッファに格納されます。その後、カラープレーンは1つのDMAチャネルを使用して順次出力されます。 |
|
このRGBカラープレーン分離ソリューションでは、カラープレーンはDMAチャネルを介して順番に出力されます。これは、RGB入力を各コンポーネントに分割し、3つのImageBufferモジュールに色を個別にバッファリングすることによって実現されます。InsertImage InsertImageを使用すると、 ImageBufferからカラープレーンが順番に読み取られます。
この例では、データをImageBufferに書き込む前に並列度を上げることが重要です。そうしないと、 InsertImage モジュール。
この方式の利点は、必要なDMAチャネルが1つだけで済むため、必要なリソースを削減できることです。また、シーケンシャル出力の場合、レイテンシは理論上の最小値となります。赤色チャネルのDMA転送は遅延なく即座に開始されます。この方式の欠点は、フレームグラバーメモリオペレータが3つ必要になることです。これらのオペレータの数には限りがあるため、この方式は、これ以上のバッファが必要ない場合にのみ有効です。
| 概要 | |
|---|---|
|
ファイル: \examples\Processing\Color\ColorPlaneSeparation\ColorPlaneSeparation_Option3_SequentialMultiROI.va |
 |
|
デフォルトプラットフォーム: mE5-MA-VCL |
|
|
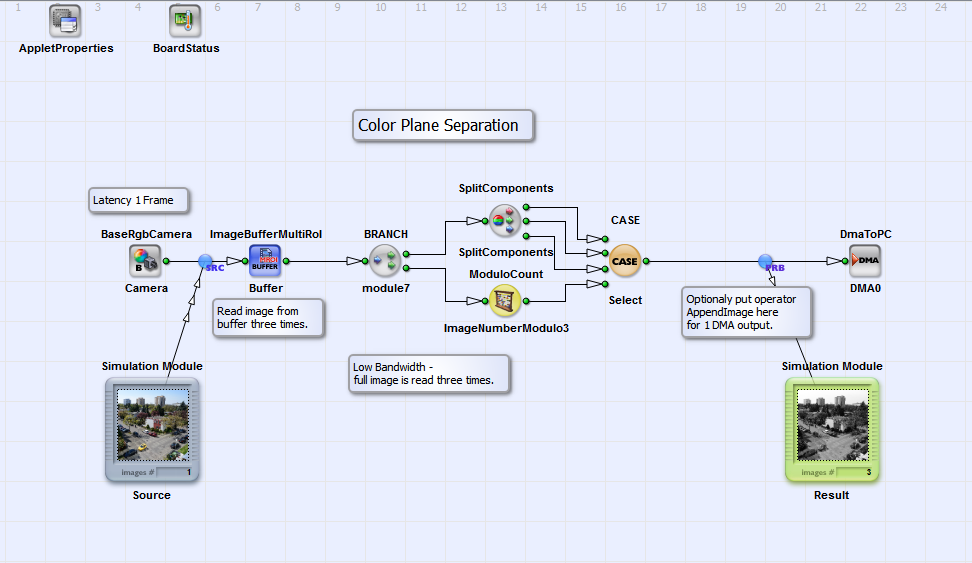
簡単な説明 RGBカラープレーン分離の例。3つのRGBカラープレーンを順次DMA出力します。このシーケンスはImageBufferMultiRoIによって生成されます。このソリューションは帯域幅を制限するため、適切ではありません。最適化されたソリューションについては、次の例を参照してください。 |
|
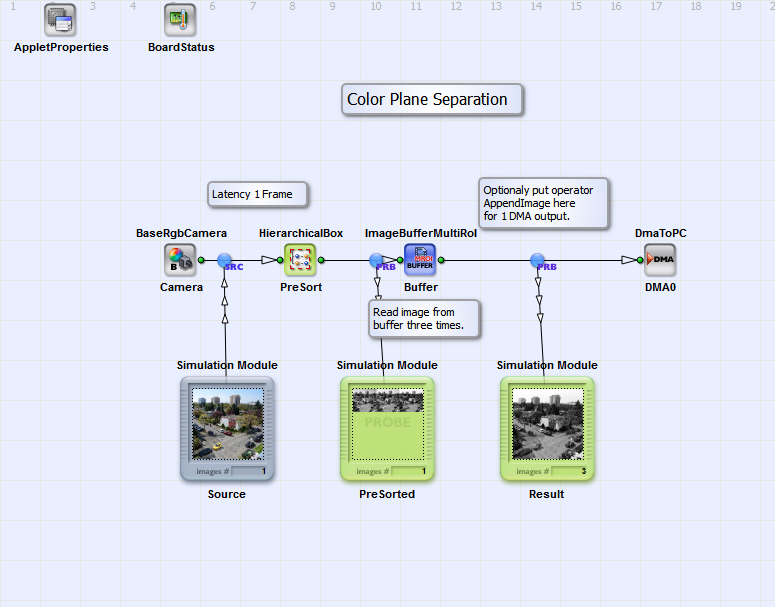
このソリューションは、前の例と次の例の間の中間ステップです。帯域幅の制限のため、このソリューションを実装することは推奨されません。ただし、フレームグラバー RAM を 1 つだけ必要として、前の例と同じ出力を取得する方法を簡単な方法で説明しています。画像をシーケンシャル化するために、演算子ImageBufferMultiRoIを使用します。この演算子では、同じ画像を 3 回読み込むだけです。その後、最初の画像には赤のコンポーネント、2 番目の画像には緑、3 番目の画像には青のコンポーネントを選択します。これは、 ModuloCountおよびCASE演算子を使用して簡単に実行できます。ModuloCountは、フレーム番号を 3 で割った余りをカウントするようにパラメータ化されています。つまり、{0, 1, 2, 0, 1, 2, ...} です。
前述のとおり、このソリューションは帯域幅を減少させるため最適ではありません。その理由は、同じ入力画像を3回読み込むものの、3つのコンポーネントのうち1つしか使用しないためです。つまり、読み込みサイクルごとにデータの3分の2を破棄することになります。次の例では、この制限を克服する同様のソリューションを示します。
| 概要 | |
|---|---|
|
ファイル: \examples\Processing\Color\ColorPlaneSeparation\ColorPlaneSeparation_Option4_SequentialPreSortMultiROI.va |
 |
|
デフォルトプラットフォーム: mE5-MA-VCL |
|
|
簡単な説明 RGBカラープレーン分離の例。3つのRGBカラープレーンを順次DMA出力します。このシーケンスはImageBufferMultiRoIによって生成されます。追加の事前ソートにより帯域幅が最適化され、前の例で示した問題が解決されます。 |
|
この例は前の例と似ています。ただし、この場合は帯域幅の制限はありません。基本的な考え方は同じです。ImageBufferMultiRoI演算子を使用して、3 つのカラーコンポーネントを順番に並べます。前の例とは異なり、バッファの後で色を分離しません。代わりに、バッファに書き込む前に色を分離します。これは、次の図に示すHierarchicalBox PreSort で行われます。
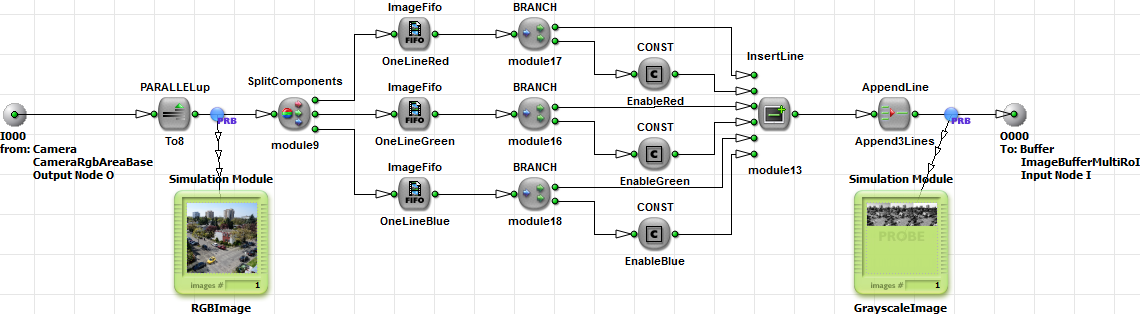
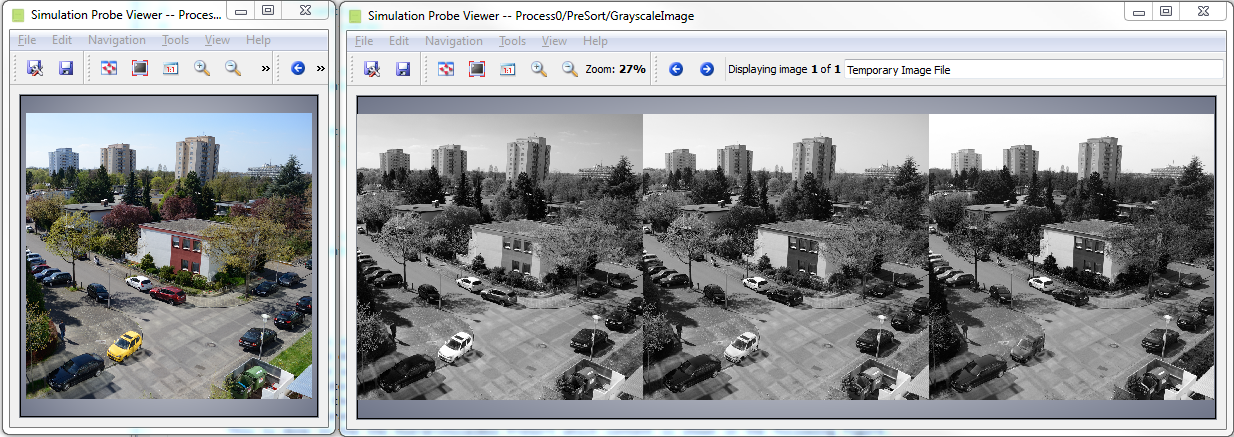
このアプローチの基本的な考え方は、カラーコンポーネントをバッファに書き込む前に分離することです。これは画像の各行に対して行われます。つまり、カラーコンポーネントを3つのリンクに分割します。こうして得られたグレースケールリンクには、入力画像の画像行が含まれます。次に、これらの行を多重化して連結します。その結果、1つの大きな画像の中に3つのグレースケール画像が得られます。左側に赤、中央に緑、右側に青のコンポーネントが配置されます。実装を理解するために、次の図のシミュレーション結果をご覧ください。
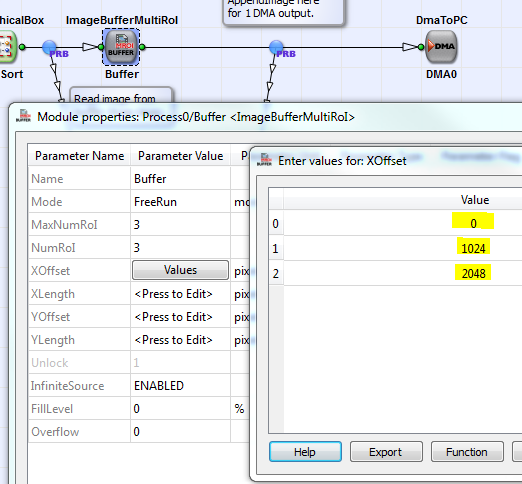
ImageBufferMultiRoIでは、まず左側の部分を読み込み、次に中央部分、最後に右側の部分を読み込む必要があります。そのため、以下に示すように、各ROIごとに異なるXOffsetを設定する必要があります。
使用する際は、例に示すように、コンポーネントを分離する前に並列度を上げることを忘れないでください。これは、InsertLineモジュールの後にボトルネックが発生するのを避けるために必要です。転送する画像は24ビットRGB画像ではなく8ビットグレースケール画像であるため、入力の少なくとも3倍の並列度が必要です。
このソリューションでは、DRAMオペレータは1つしか必要とせず、帯域幅も制限されません。これは最適化されたソリューションです。ただし、FIFO内の分離されたコンポーネントラインをバッファリングするために、ブロックRAMが必要になります。小さな画像であれば、これは問題になりません。しかし、1ラインあたり16384ピクセルといった大きな画像幅の場合は、多くのブロックRAMが必要になります。この最後の欠点は、次の例で解決されます。
| 概要 | |
|---|---|
|
ファイル: \examples\Processing\Color\ColorPlaneSeparation\ColorPlaneSeparation_Option5_SequentialAdvanced.va |
 |
|
デフォルトプラットフォーム: mE5-MA-VCL |
|
|
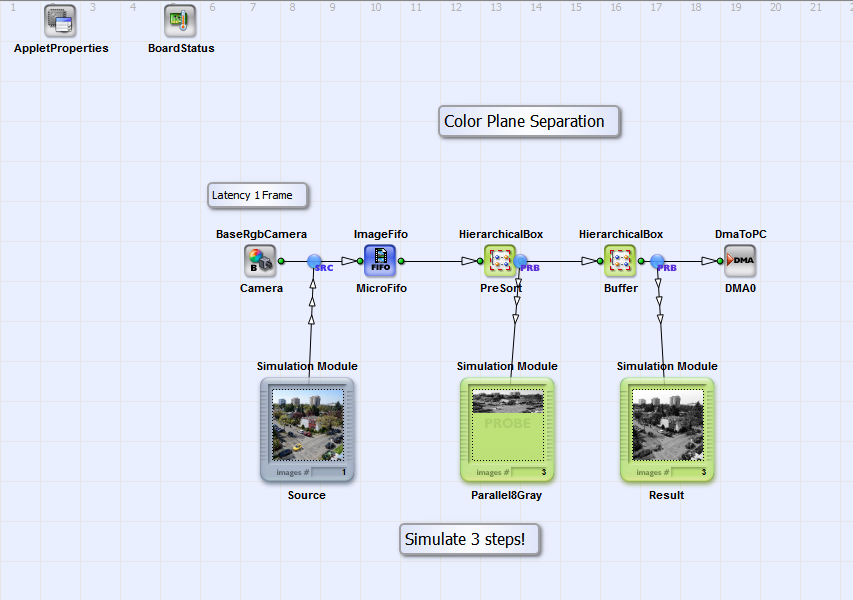
簡単な説明 カラープレーンの分離の例。RGB入力は各コンポーネントに分割され、1つのDMAチャネルを介して順次出力されます。分割は、同じコンポーネントを並列ワードに収集し、 FrameBufferRandomReadで読み取ることによって実行されます。 |
|
これはカラープレーン分離の最も高度な例ですVisualApplets . 最小限のリソース使用量と最大限の帯域幅に焦点を当てています。前の例では、カラーコンポーネントを分離するために事前ソートを使用して、バッファから個別に読み取ることができました。ただし、事前ソートの FIFO にはブロック RAM が必要です。このアプローチでも事前ソートを使用します。対照的に、次のコンポーネントに切り替える前に、各カラーコンポーネントの 8 つの連続するピクセルのみを収集します。前の例では、次の行に切り替える前に、1 つのコンポーネントの行全体を収集していました。この変更により、FIFO は不要になります。ただし、この場合ImageBufferMultiRoIは使用できません。代わりに、 FrameBufferRandomReadを使用する必要があります。
事前ソーティングは簡単です。 まず、Parallelismを8に増やします。 次に、コンポーネントが分割されます。 これにより、それぞれParallelismが8の3つのリンクが得られます。 これで、MergeParallelによってコンポーネントの8ピクセルがシーケンスにまとめられます。 その結果、R0〜R7、G0〜G7、B0〜B7、R8〜R15、G8〜G15、B8〜B15、...というシーケンスが得られます。
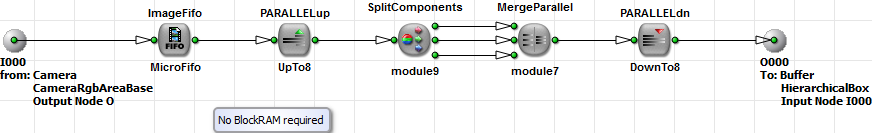
PARALLELdnが16から8に変更されるため、入力にFIFOが必要です。 このFIFOは、DRCレベル2エラーを回避するためだけに必要です。 実際にはデータをバッファリングする必要がないため、2ピクセルというごく小さなサイズに設定します。
ピクセルの事前ソーティングを行った後、それらはFrameBufferRandomReadオペレータでバッファリングされます。 このオペレータには行アドレスと列アドレスの入力があり、データをランダムに読み取ることができます。
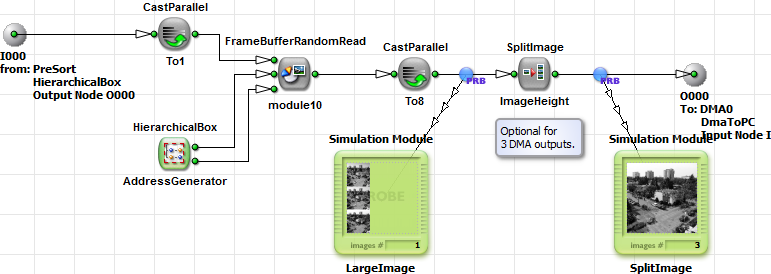
このオペレータは、Parallelismが1の場合にのみ使用できます。 したがって、CastParallelを使用して、1ピクセルあたり8ビットのParallelism 8から、1ピクセルあたり64ビットのParallelism 1にキャストします。 これが、前のステップで連続する8ピクセルを収集した理由です。
色成分を分離するには、不要な色をスキップするためにアドレスを2つずつ増やす必要があります。 赤成分の場合、読み取りアドレスは次のようになります:RColA(0) = 0、RColA(1) = 2、RColA(2) = 5、... 緑成分の場合、読み取りアドレスは次のようになります:RColA(0) = 1、RColA(1) = 3、RColA(2) = 6、... 階層化されたボックスのAddressGeneratorがこれらの読み取りアドレスを生成します。 CreateBlankImageオペレータが必要な画像寸法を定義します。 前述のようにCastParallelで8から1へ変換したため、画像幅を8で割る必要があります。
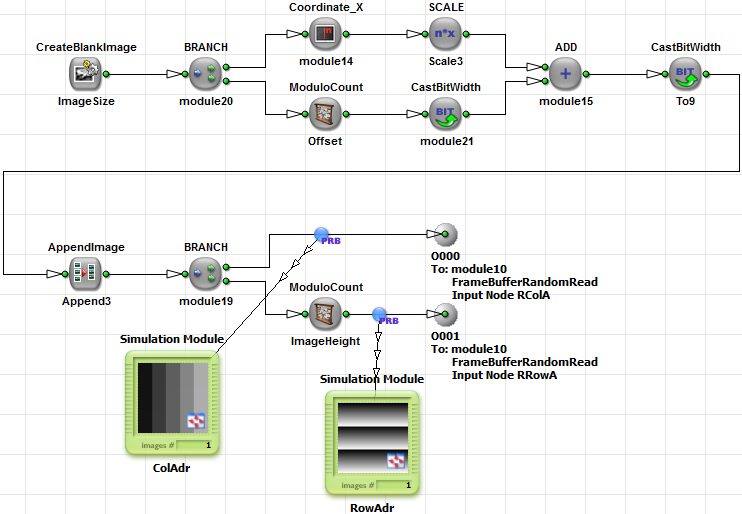
列アドレスは、Coordinate_Xの出力をScalingして3倍にすることで簡単に生成されます。 現在のコンポーネントに応じて、値にオフセットとして0、1、または2を追加します。
AppendImageを使用すると、3つのアドレス画像が1つの大きな画像に結合されます。 行アドレスは、0から画像高さまでのCounterを使用して簡単に生成されます。 この場合、このタスクにModuloCountオペレータを使用します。 これで、アドレスをFrameBufferRandomReadオペレータに入力できるようになりました。 FrameBufferRandomReadのパフォーマンスを最大化するために、CreatBlankImage出力でParallelismを2に設定することを忘れないでください。
バッファの後、最初の行に赤の画像が含まれ、その後に緑の画像、そして最後に青の画像が含まれる大きな画像が得られます。 この大きな画像を3つの個別のDMA出力に分割するために、SplitImageを使用して画像の高さを設定します。
実装を理解する最も簡単な方法は、中間結果を段階的に確認することです。 1つの結果画像に対して3つのステップをシミュレートする必要があることに注意してください。 これは、オペレータCreateBlankImageによって3つの画像を生成する必要があるためです。
このソリューションはリソースが最適化されており、必要なブロックRAMリソースが少なくなっています。 さらに、FPGAロジックリソースが効率的に使用されます。 アドレス生成に必要なリソースもごくわずかです。
 前へ

