目次
以下のリストは、このVisualAppletsバージョンでサポートされているすべてのハードウェアプラットフォームの重要なハードウェア詳細を示しています。詳細なリストについては、各製品のデータシートをご確認ください。
| リソース | imaFlex CXP-12 Quad | imaFlex CXP-12 Penta | imaFlex 2 Dual 100 | ||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| ビジョンプロセッサ | Xilinx UltraScale+ XCKU3P-FFVD900-1-E | Xilinx UltraScale+ XCKU3P-FFVB676-1-E | Xilinx UltraScale+ XCKU15P-FFVE1517-1-E | ||||||||||
| LUT | 160679 | 161049 | 447992 | ||||||||||
| フリップフロップ | 323224 | 323216 | 895984 | ||||||||||
| ブロックRAM (18k) | 720 | 720 | 1776 | ||||||||||
| URAMブロック (288k) | 48 | 48 | 128 | ||||||||||
| 組込み算術論理ユニット (DSP48) | 1368 | 1368 | 1800 | ||||||||||
| RAMサイズ | 3 x 512 MiB DDR4 | 5 x 512 MiB DDR4 | 2 @ 5 x 1024 MiB DDR4 | ||||||||||
| RAMデータ幅 | 384 Bit | 640 Bit | 640 Bit | ||||||||||
| RAM合計帯域幅 (共有) | 14.4 GB/ |
24.0 GB/s |
2 @ 24.0 GB/s |
||||||||||
| ベースデザインクロック (デフォルト) | 312.5 MHz |
312.5 MHz |
391.5 MHz |
||||||||||
| ベースデザインクロック(最大) | 400.0 MHz | 400.0 MHz | 420.0 MHz | ||||||||||
| ホストインターフェース | PCIe x 8 Gen 3(ダイレクトメモリアクセス) | PCIe x 8 Gen 3(ダイレクトメモリアクセス) | PCIe x 16 Gen 3(ダイレクトメモリアクセス) | ||||||||||
| ホストインターフェイス(PCIe x 8 Gen 3)帯域幅(理論値) | 8000 MB/s | 8000 MB/s | 16000 MB/s | ||||||||||
| ホストインターフェイス(PCIe x 8 Gen 3)帯域幅(通常値/最大値) | 7200 MB/s(持続データ帯域幅) | 7200 MB/s(持続データ帯域幅) | 13000 MB/s(持続データ帯域幅) |
||||||||||
|
|||||||||||||
表 68. imaFlex プラットフォームのハードウェア構成
| リソース | mE5 marathon VCX-QP | mE5 marathon VCL | mE5 marathon VCLx | ||||
|---|---|---|---|---|---|---|---|
| ビジョンプロセッサ | Xilinx Kintex7 XC7K160T - 2FFG676C FPGA | Xilinx Kintex7 XC7K160T - 1FBG676C FPGA | Xilinx Kintex7 XC7K410T - 1FBG676C FPGA | ||||
| LUT | 101400 | 101400 | 254200 | ||||
| フリップフロップ | 202800 | 202800 | 508400 | ||||
| ブロックRAM (18k) | 650 | 650 | 1590 | ||||
| 組込み算術論理ユニット (DSP48) | 600 | 600 | 1540 | ||||
| RAMサイズ | 4 x 512MiB DDR3 | 4 x 512MiB DDR3 | 4 x 512MiB DDR3 | ||||
| RAMデータ幅 | 512 Bit | 256 Bit | 256 Bit | ||||
| RAM合計帯域幅 (共有) | 12.8 GB/s |
6.4 GB/s |
6.4 GB/s |
||||
| ベースデザインクロック (デフォルト) | 125MHz | 125MHz | 125MHz | ||||
| ベースデザインクロック(最大) | 312.5 MHz |
312.5 MHz |
312.5 MHz |
||||
| ホストインターフェース | PCIe x 4 Gen 2 (Direct Memory Access) | PCIe x 4 Gen 2 (Direct Memory Access) | PCIe x 4 Gen 2 (Direct Memory Access) | ||||
| ホストインターフェース (PCIe x 4 Gen 2) 帯域幅 (理論値) | 1x2000 MB/s | 1x2000 MB/s | 1x2000 MB/s | ||||
| ホストインターフェース (PCIe x 4 Gen 2) 帯域幅 (標準/最大) | 最大 1800 MB/s の持続データ帯域幅 | 最大 1800 MB/s の持続データ帯域幅 | 最大 1800 MB/s の持続データ帯域幅 | ||||
|
|
|||||||
表 69. ハードウェア構成 microEnable 5 marathon
デバイスリソースは各ハードウェアプラットフォームで制限されています。以下のリストは、サポートされているすべてのプラットフォームで使用可能なリソースを示しています。オペレーターはデバイスリソースを消費し、ほとんどのリソースインスタンスは1回のみ使用できます。この規則には、GPIオペレーターなどの例外がいくつかあります。これらの場合、リソース消費はオペレーターリファレンスドキュメントに記載されています。
デバイスリソースの割り当て方法:
-
自動,
-
オペレーターパラメータを使用する、または
-
Resourcesダイアログで行われます。
詳細については、'Allocation of Device Resources'を参照してください。
| リソース | imaFlex 2 Dual 100 | ||||||||
|---|---|---|---|---|---|---|---|---|---|
| Port[0] CoF Lane |
4 | ||||||||
| Port[1] CoF Lane |
4 | ||||||||
| Port[0] CoF RX Trigger Lane |
4 | ||||||||
| Port[1] CoF RX Trigger Lane |
4 | ||||||||
| Port[0] CoF TX Trigger Lane |
4 | ||||||||
| Port[1] CoF TX Trigger Lane |
4 | ||||||||
| Port[0] CoF Status Lane |
4 | ||||||||
| Port[1] CoF Status Lane |
4 | ||||||||
| Port[0] DF RX Data Lane |
4 | ||||||||
| Port[1] DF RX Data Lane |
4 | ||||||||
| Port[0] DF RX Meta Lane |
4 | ||||||||
| Port[1] DF RX Meta Lane |
4 | ||||||||
| Port[0] DF TX Data Lane |
4 | ||||||||
| Port[1] DF TX Data Lane |
4 | ||||||||
| Port[0] DF TX Meta Lane |
4 | ||||||||
| Port[1] DF TX Meta Lane |
4 | ||||||||
| Port[0] DF Green LED Lane |
4 | ||||||||
| Port[0] DF Red LED Lane |
4 | ||||||||
| Port[1] DF Green LED |
1 | ||||||||
| Port[1] DF Red LED |
1 | ||||||||
| DmaToHostPort |
5 | ||||||||
| DmaFromHostPort |
1 | ||||||||
| GPI |
16 | ||||||||
| GPO |
16 | ||||||||
| EventPort |
31 | ||||||||
| EventID |
64 | ||||||||
| User LED |
6 | ||||||||
| ImageChannel |
1024 | ||||||||
| RAM |
2 @ from 1 x 5 GiB to 8 x 625 MiB | ||||||||
|
|||||||||
表 70. デバイスリソースの一覧 imaFlex 2 Dual 100
| リソース | imaFlex CXP-12 Quad | imaFlex CXP-12 Penta | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| カメラポート | 4 | 5 | ||||||||||||
| CxpStatusPort | 4 | 5 | ||||||||||||
| CxpRxTriggerPort | 4 | 5 | ||||||||||||
| CxpTxTriggerPort | 4 | 5 | ||||||||||||
| DMA | 4 | 5 | ||||||||||||
| DmaFromHostPort | 1 | 1 | ||||||||||||
| GPO |
10 OUT | 12 OUT | ||||||||||||
| GPI |
12 IN | 12 IN | ||||||||||||
| LED Ports |
6 | 6 | ||||||||||||
| SignalChannel |
4000 | 4000 | ||||||||||||
| EventPort |
32 | 32 | ||||||||||||
| EventID |
64 | 64 | ||||||||||||
| ImageChannel |
1024 | 1024 | ||||||||||||
RAM |
1 x 1.5 GiB から 8 x 192 MiB まで | 1 x 2.5 GiB から 8 x 320 MiB まで | ||||||||||||
|
||||||||||||||
表 71. デバイスリソースの一覧 imaFlex CXP-12 Quad および imaFlex CXP-12 Penta
表 72. デバイスリソースの一覧 microEnable 5 marathon
imaFlex 2 Dual 100プラットフォームには、それぞれ5 GiBの容量を持つ2つの別個の物理RAMバンクが含まれています。これらの物理バンクは、アプレットで使用されるRAMベースのVisualAppletsオペレーターの数に応じて、必要に応じて重複しないメモリ領域に分割されます。VisualApplets内では、これらの領域は仮想RAMバンクとして表示されます。オペレーターがRAMを必要とすると、仮想RAMバンクを予約します。これは、物理RAM内の専用の重複しない領域に対応します。
VisualAppletsのメモリオペレーターに関する実践的なガイダンスについては、Memory Elementsチュートリアルのトピックを参照してください。
imaFlex 2 Dual 100プラットフォームでは、物理RAMバンクあたり最大8つの重複しないメモリ領域を定義できます。つまり、両方のRAMインターフェイスあわせて合計16の領域になります。1つの物理インターフェイスに割り当てられているRAMオペレーターが1つだけの場合、そのインターフェイスの5 GiBの容量全体にアクセスできます。複数のオペレーターが同じ物理インターフェイスを共有する場合、利用可能なメモリはそれらの間で比例して分割されます。たとえば、8つのオペレーターが同じインターフェイスに割り当てられている場合、各オペレーターは5 GiBメモリの1/8を受け取り、オペレーターあたり約0.625 GiBになります。
imaFlex 2 Dual 100上のRAM帯域幅は、同じ物理インターフェイスに接続されているすべてのオペレーター間で均等に共有されます。特定の単一オペレーター専用ではありません。
-
デザインが1つのインターフェイス上の8つのRAMリソースすべてを使用する場合、各RAMベースのオペレーターは、オペレーターの効率係数によって調整された、合計インターフェイス帯域幅の約1/8を受け取ります。
-
RAMベースのオペレーターが1つだけ使用されている場合、そのインターフェースの最大帯域幅をフルに活用できます。
-
2つのオペレーターが同じインターフェースを共有する場合、それぞれが総帯域幅の半分を取得し、以下同様となります。
プラットフォームの2つの物理RAMインターフェースは、VisualApplets内の16個の仮想RAMポートにマッピングされます。最初のRAMインターフェースはRAMリソースインデックス0~7にマッピングされ、2番目のRAMインターフェースはRAMリソースインデックス8~15にマッピングされます。
割り当てられていない(したがって使用されていない)RAMポートは、メモリ容量の0%を受け取ります。これは、利用可能な総メモリが、RAMポートをアクティブに使用しているオペレーターの間でのみ分割されることを意味します。
-
1つのポートのみを使用する場合:そのポートは利用可能なメモリの100%を受け取ります。
-
2つのポートを使用する場合:各ポートは利用可能なメモリの50%を受け取ります。
-
3つのポートを使用する場合:リソースIDが最も低いポートが50%を受け取り、残りの2つのポートがそれぞれ25%を受け取ります。
-
4つのポートを使用する場合:4つのポートすべてがそれぞれ25%を受け取ります。
-
5つのポートを使用する場合:最初の3つのポート(リソースIDが最も低いもの)がそれぞれ25%を受け取り、残りの2つのポートがそれぞれ12.5%を受け取ります。
-
6つのポートを使用する場合:リソースIDが最も低い2つのポートがそれぞれ25%を受け取り、他の4つのポートがそれぞれ12.5%を受け取ります。
-
7つのポートを使用する場合:リソースIDが最も低いポートが25%を受け取り、他の6つのポートがそれぞれ12.5%を受け取ります。
-
8つのポートを使用する場合:すべてのポートがそれぞれ12.5%を受け取ります。
 |
非対称メモリ割り当て |
|---|---|
|
非対称サイズ分割の場合、同じ物理バンク内で最も低いRAMインデックスを持つポートにより多くの割り当てが与えられます。たとえば、3つのRAMポート(0、1、2)を使用する場合、ポート0はRAMサイズの50%を受け取り、ポート1および2はそれぞれ25%を受け取ります。ポートが8、9、10である場合も同様です。これらは2番目のRAMインターフェースにマッピングされますが、同じ物理RAMバンクに属しているためです。 |
RAMインデックスは連続している必要はなく、その絶対的な順序によって割り当てが決まります。RAMインデックスは仮想識別子であり、シーケンスに抜けがある場合でも、FPGAリソースの使用量には影響しません。たとえば、3つのRAMポート(1、5、7)を使用する場合:ポート1はRAMサイズの50%を受け取り、ポート5および7はそれぞれ25%を受け取ります。
すべてのリソースが同じ物理バンクにマッピングされる場合、RAMインデックスの割り当て方法による有利不利はありません。VisualAppletsが提供する自動割り当てを使用するか、特定的设计オペレーターが他のオペレーターよりも多くのRAMを必要とする場合は手動で調整できます。
|
独立したRAMインターフェース |
|---|---|
|
両方の物理RAMインターフェースは完全に独立しています。たとえば、2つのオペレーターを使用し、一方が最初のRAMインターフェースに割り当てられ、もう一方が2番目に割り当てられている場合、各オペレーターはそれぞれのインターフェースの最大RAMサイズをフルに活用できます。 |
共有メモリコントローラーは、ラウンドロビンアルゴリズムを使用して、物理RAMインターフェース内のすべての割り当てられたポートに帯域幅を均等に分散します。このアルゴリズムは、クレジットベースの調停スキームに基づいています。ポートがアクティブになると、新しいRAMジョブを提供し続ける限り、設定された数のクレジットクロックサイクルの間アクティブ状態を維持します。アクティブなポートにジョブがなくなると、非アクティブ化され、アクティベーションのトークンは保留中のリクエストを持つ次のポートに移動します。これにより、アイドル状態のポートで帯域幅が無駄になることがなくなります。
クレジット値は、使用されるRAMオペレーターの数に基づいて、アプレットの合成時にファームウェアによってプログラムされます。これらは、実行時やFramegrabber SDKを通じて変更することはできません。ユーザーはクレジット設定にアクセスできません。
ポートがアクティブな間は、メモリコントローラーの帯域幅の100%を持ちます。物理バンク内の8つのポートすべてが均等にアクティブである場合、各ポートは時間の経過とともに総帯域幅の約1/8を受け取ります。その他の場合、実際の平均帯域幅は各ポートの負荷によって異なります。
物理RAMインターフェースは完全に独立しています。RAMベースのオペレーターを異なるインターフェースに割り当てることで、帯域幅の効率を最大化できます。帯域幅は、同じ物理RAMインターフェースに接続されているオペレーターの間でのみ共有されます。
プラットフォームのimaFlex CXP-12 QuadおよびimaFlex CXP-12 Pentaには、1つの物理RAMバンクのみが搭載されています(そのサイズはプラットフォーム固有です)。この単一の物理バンクは、アプレット内で使用されるRAMベースのVisualAppletsオペレーターの量に応じて、重ならない領域に動的にフォーマットされます。これらの領域は、VisualApplets内で仮想RAMバンクとして表現されます。オペレーターがRAMリソースを予約すると、物理RAM内の排他的で重ならないメモリ領域にマッピングされた仮想RAMバンクを使用することになります。imaFlexプラットフォームでは、最大8つの重ならない領域を定義できます。1つのRAMオペレーターのみを使用する場合、オペレーターはプラットフォームの完全なRAMサイズを取得します。追加のオペレーターごとに割り当てられるサイズは、同じ物理インターフェースにドッキングするオペレーターの量に比例して、オペレーターが所有するサイズを減らします。8つのオペレーターを使用する場合、各オペレーターはプラットフォームメモリサイズの1/8を割り当てます。
ただし、RAMの帯域幅は、設計内のすべてのRAMベースのオペレーター間で共有されます。設計で8つのRAMリソースすべてを利用する場合、8つのRAMベースのオペレーターのそれぞれが、その特定のオペレーターの効率係数を差し引いた最大1/8 GB/sの専用帯域幅を持つことができます。設計でRAMベースのオペレーターが1つだけ使用されている場合、このオペレーターはプラットフォームの総帯域幅を取得します。2つのオペレーターを使用する場合、2つのオペレーターのそれぞれが総帯域幅の半分を取得し、以下同様となります。
割り当てられていないため使用されないRAMポートには、常にメモリサイズの0%が割り当てられます。
-
1つのポートを使用する場合:使用されるポートに100%が割り当てられます。
-
2つのポートを使用する場合:両方の使用されるポートに50%が割り当てられます。
-
3つのポートを使用する場合:リソースID番号が最も小さいポートに50%、その他の2つの使用されるポートにそれぞれ25%が割り当てられます。
-
4つのポートを使用する場合:4つのポートすべてに25%が割り当てられます。
-
5つのポートを使用する場合:リソースID番号が最も小さい3つのポートに25%、残りの2つのポートに12.5%が割り当てられます。
-
6つのポートを使用する場合:リソースID番号が最も小さい2つのポートに25%、残りの4つのポートに12.5%が割り当てられます。
-
7つのポートを使用する場合:リソースID番号が最も小さいポートに25%、残りの6つのポートに12.5%が割り当てられます。
-
8つのポートを使用する場合:すべてのポートに12.5%が割り当てられます。
|
|
|
非対称なサイズ分割の場合、RAMインデックスが小さいポートほど大きな割り当てを受け取ります。例えば、3つのRAMポート(0、1、2)を使用する場合、ポート0には50%のRAMサイズが割り当てられ、ポート1とポート2にはそれぞれ25%ずつ割り当てられます。 RAMインデックスは連続していなくてもよく、その絶対的な順序によって割り当てが決定されます。RAMインデックスは仮想番号であり、順序にギャップがある場合でもFPGAリソースの使用量には影響しません。例えば、3つのRAMポート(1、5、7)を使用する場合、ポート1には50%のRAMサイズが割り当てられ、ポート5とポート7にはそれぞれ25%ずつ割り当てられます。 オペレータのRAMインデックスを割り当てる際に有利不利はありません。VisualAppletsの自動割り当てを使用するか、特殊なデザインオペレータが他のオペレータよりも多くのRAMサイズを必要とする場合に手動で調整してください。 |
共有メモリコントローラはラウンドロビンアルゴリズムを適用し、割り当てられたすべてのポートに帯域幅を均等に分散します。このアルゴリズムではクレジット調停スキームが使用されます。ポートがアクティブになると、そのポートが新しいRAMジョブを提供している限り、クレジットのクロックサイクルの間アクティブ状態を維持できます。アクティブになったポートにジョブがなくなると、そのポートは非アクティブ化され、アクティトークンはリクエストジョブが保留されている次の順番のポートに移行します。これにより、アイドル状態で帯域幅が無駄になることはありません。クレジットは、使用されるRAMオペレータの量に応じてアプレットの合成中にファームウェアによって排他的にプログラムされ、Framegrabber SDK/実行時に変更することはできません。ユーザーはクレジットのプログラミングにアクセスできません。アクティブなポートがRAMインターフェースを占有している間、メモリコントローラの100%の帯域幅にアクセスできます。8つのポートすべてが使用され、均等にアクティブである場合、時間の経過に伴う結果の帯域幅は各ポートにつき1/8になります。それ以外の場合、ポート上の負荷によって各ポートの実効平均帯域幅が定義されます。
microEnable 5 marathonプラットフォームには、物理RAMバンクが1つだけ(サイズはプラットフォーム固有)搭載されています。この単一の物理バンクは、重複しない4つのメモリ領域にフォーマットされます。これら4つの領域は、VisualApplets内で4つの仮想RAMバンクとして表現されます。オペレータがRAMリソースを予約すると、物理RAM内の重複しない排他的なメモリ領域にマップされる仮想RAMバンクを使用することになります。
ただし、RAMの帯域幅はデザイン内のすべてのRAMベースのオペレータ間で共有されます。デザインが4つのRAMリソースすべてを利用する場合、4つのRAMベースのオペレータのそれぞれが、その特定のオペレータの効率係数を差し引いた最大1.6 GB/sの排他帯域幅を持つことができます。デザイン内でRAMベースのオペレータが1つだけ使用される場合、このオペレータは6.4 GB/sの合計帯域幅を取得します。2つのオペレータが使用される場合、2つのオペレータのそれぞれが合計帯域幅の半分を取得します。
|
オペレータごとの帯域幅 |
|---|---|
|
オンボードRAMは合計6.4GB/sの帯域幅を提供します。個々のRAMベースのオペレータで使用可能な帯域幅は、合計帯域幅をデザイン内でインスタンス化されたすべてのRAMベースのオペレータの数で割った値になります。 |
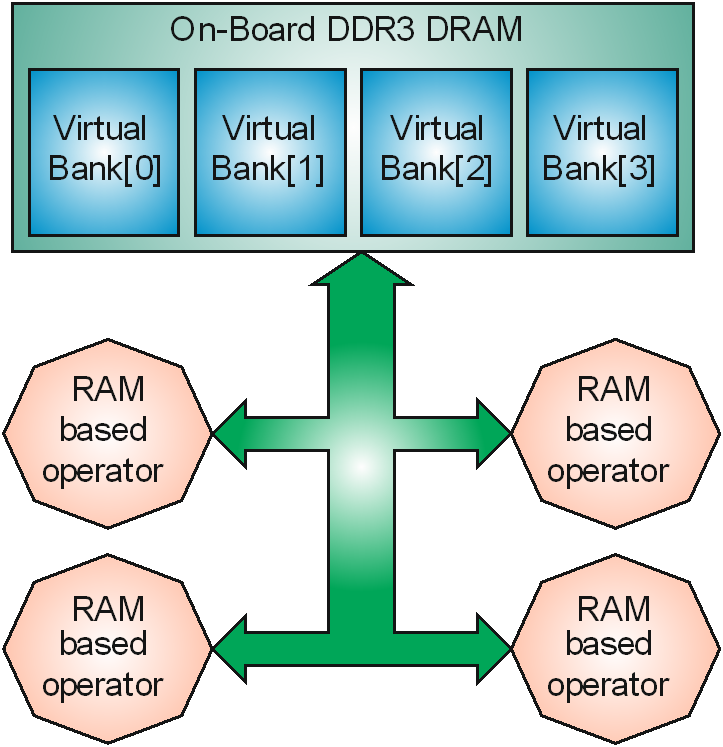
RAMベースのオペレータを使用して設計を行う際には、このRAMアーキテクチャを考慮する必要があります。
帯域幅共有アーキテクチャのため、複数のRAMベースのオペレータを使用する場合でも、単一のRAMオペレータの入力に必要な帯域幅が少なくても、アプレット開発者はオペレータのメモリインターフェースの256ビットすべて(RAM Data Width)を利用して、メモリインターフェースを介したスループットを最大限に高める必要があります。
imaFlex 2 Dual 100には、C0とC1の2つのQSFP28ファイバーコネクタが用意されています。

両方のコネクタがCoF(CXP over Fiber)およびデータ転送プロトコルをサポートしています。各ファイバーコネクタには独自のLEDがあります。コネクタC0には4つのLEDが割り当てられ、コネクタC1には1つのLEDが割り当てられています。
各コネクタはQSFP28光モジュールをサポートしています。QSFP28インターフェースは、双方向に4つのファイバー接続(4つのRX接続と4つのTX接続)を提供します。ファイバー接続は、オペレータードキュメントにおいてレーンと呼ばれます。各QSFP28ポートには、RXおよびTX方向の両方に0〜3のラベルが付いた4つのファイバーレーンがあります。各レーンは25 Gbit/sで動作します。したがって、1つのQSFP28コネクタで、TXおよびRX方向に合計100 Gbit/sの累積帯域幅を伝送できます。

imaFlex 2 Dual 100は、複数のフレームグラバー間でデータを双方向に転送するためのデータフォワーディング機能を提供します。VisualAppletsにおけるデータフォワーディングは、デイジーチェーンやより高度なモデルなど、データおよびメタデータを転送するためのさまざまなトポロジーをサポートします。データフォワーディングの動作は、VisualAppletsオペレーターを通じてユーザーが完全に制御します。カメラデータ、アプレット生成データ、およびメタデータは、TXおよびRXの両方向で独立して伝送できます。また、VisualAppletsはレーンを多重化し、2つの独立した仮想チャネルを使用して、単一のファイバーレーン上でメタデータと通常の間画像データを同時に送信できるようにします。メタデータは、タイムリーな配信を確保するために優先されます。
ファイバー技術は双方向通信をサポートしているため、高度なマスター・スレーブアプリケーションにより、マスターがスレーブデバイスの受信データを制御し、そこから処理結果を収集できるようになります。スレーブのGPUまたはCPUで生成された処理結果は、DmaFromPCを介して転送され、データフォワーディングデータオペレーターを通じてマスターフレームグラバーに送り返されます。
一般的なデータフォワーディングのデイジーチェーン構成では、選択されたカメラデータが複数のフレームグラバーに転送されます。これらのフレームグラバーは、非常に低いレイテンシーでPCIe経由で外部GPUにデータを送信します。


CoF(CXP over Fiber)は、4つのダウンストリーム接続と1つのアップストリーム接続を使用します。2つのフレームグラバー間のデータフォワーディングリンクは、必要なデータのみを送信するように構成されており、ネイティブのCoFトラフィックではなく、VisualAppletsのデータおよびメタデータストリームを伝送します。CoFとデータフォワーディングはどちらも前方誤り訂正(FEC)によって保護されています。
マスターフレームグラバーはカメラに接続し、選択したデータ部分を次のスレーブフレームグラバーに転送します。各スレーブフレームグラバーは自身の処理に必要なデータを抽出し、イメージストリームの残りの未処理の部分をシーケンス内の次のスレーブに転送します。チェーン内の最後のフレームグラバーはエンドポイントとして機能し、データをそれ以上転送しません。
上記の例は、デイジーチェーンのトポロジーを簡略化した表現です。より高度な構成では、接続された2つのフレームグラバー間でデータを自由に交換できます。つまり、相互間に1、2、3、または4レーンの接続を張ることができます。RX方向とTX方向では、異なる数のレーンを使用できます。
複数の光レーンを仮想チャネルに統合できるため、単一の複数のデータチャネルを単一のQSFP28コネクタ経由で伝送できます。画像データの伝送に加えて、VisualAppletsは各光レーンに対して専用のメタチャネルを提供します。このメタチャネルは通常の画像データよりも優先され、非常に低いジッターとレイテンシーで伝送されるため、アプリケーションでタイムスタンプやボード間の同期を実装できるようになります。また、ファイバー接続の反対側にいるスレーブパートナーを設定するなど、小さなサイドバンド情報もメタチャネルを介して伝送できます。パートナーは、自身のメタチャネルを介して制御およびステータス情報をマスターに送り返すことができます。また、各フレームグラバーは、最大100 Gb/sの集約帯域幅で処理済み画像データをパートナーに送信することもできます。
単一のQSFP28インターフェースを介して、2つのフレームグラバー間に最大4つのメタチャネルをTX方向とRX方向に独立して張ることができます。各メタチャネルは25 Gb/sで動作します。画像データチャネルは、1、2、3、または4つの光レーンにまたがって仮想データ伝送チャネルを形成できます。
QSFP28データフォワーディングインターフェースでは、仮想データチャネルの以下の組み合わせが可能です。
-
1 x4チャネル:100 Gbit/s
-
75 Gbit/sで動作する1 x3チャネルおよび25 Gbit/sで動作する1 x1チャネル
-
それぞれ50 Gbit/sで動作する2 x2チャネル
-
50 Gbit/sで動作する1 x2チャネルおよび25 Gbit/sで動作する2 x1チャネル
-
それぞれ25 Gbit/sで動作する4 x1チャネル
RX側とTX側は完全に独立して動作します。つまり、逆方向(RX)の方向は、必要に応じて実装することも省略することもできます。実装する場合でも、順方向(TX)に対して対称である必要はありません。
メタチャネルとデータチャネルは独立して動作します。各メタチャネルは正確に1つのファイバーレーンを使用し、25 Gb/sで動作します。メタチャネルは少量のデータの伝送用に設計されています。優先順位があるため、メタチャネルの伝送中、同じファイバーレーン上の通常のデータ伝送は一時停止します。
データフォワーディング機能をサポートするために、VisualAppletsには以下のオペレーターが用意されています。
Baslerは、データ転送の例をVisualAppletsのデザインとして、C++ SDKコントロールアプリケーションとともに提供しています。これらの例では、データ転送にこれらのオペレーターを使用する方法を確認できます。これらの例は、VisualAppletsのサンプルとして次の場所で入手できます: Examples/Acquisition/DataForwarding。これらのデータ転送の例に関するドキュメントは、 「Data Forwarding for CoaXPress over Fiber Frame Grabber」 トピック( 基礎と例.


一定の制限の下で、より複雑なカメラとフレームグラバーのモデルも可能です。2台のフレームグラバー間の光伝送はレイテンシーが非常に低く、データワードが一方のフレームグラバーからもう一歩のフレームグラバーに移動するのにかかる時間は約120 nsです。
デイジーチェーン接続は、複数のCPU/GPUクラスター間で処理負荷を分散させるための最も一般的なアプローチです:

マスターフレームグラバーはカメラに接続され、2つ目のQSFP28ポートは次のスレーブに接続されます。各スレーブは受信データの一部を処理し、残りのデータを次のデバイスに転送します。チェーン内の最後のフレームグラバーはエンドポイントとして機能します。最後のフレームグラバーを除くすべてのフレームグラバーが、両方のQSFP28ポートを使用します。

アプリケーションによっては、2台の100 Gb/sカメラを1台のフレームグラバーに接続することが可能です。これには、カメラが最大帯域幅で動作していないこと、またはRAMにデータを保存する前にVisualAppletsで前処理を実行して帯域幅をわずかに削減し、両方のカメラストリームが2つのRAMインターフェースに収まるようにすることが必要です。この構成では、フレームグラバーはVisualAppletsで追加の処理を実行して結果のデータレートを削減し、約13 GB/sという制限されたPCIeのスループットに一致させる必要があります。

この場合、各フレームグラバーは独自のカメラに接続されます。2つ目のQSFP28ポートはフレームグラバー間通信に使用され、複雑なコンピューティングタスクや同期のために両方向に最大100 Gbit/sでのデータ交換を可能にします。

 前へ

