Pattern OCR vTool#
一般的な用途には、シリアル番号、バッチコード、または固定構造を持つその他のテキストが含まれます。このようなシナリオでは、関連する画像領域は設計上固定されているか、前処理ステップで確実に抽出および位置合わせすることができます。テキストが固定パターンに従わない場合は、代わりにFree-Form OCR vToolを使用してください。
Pattern OCR vToolは、Image入力ピンを介して受け取った画像内のテキストを読み取り、モデルによって設定されたパターンと比較します。結果は、Texts、BBoxes_px、およびScores出力ピンを介して出力されます。
検出の前にROI Creator vToolを使用して関心領域を指定する場合、Pattern OCR vToolはそのRoi入力ピンを介してROIデータを受け入れます。その場合、検出は関心領域でのみ実行されます。副次的な効果として、これにより処理が高速化されます。
Pattern OCR vToolを実行するには、pylon Supplementary Package for pylon AI 1.6.1以上が必要です。
Pattern OCR vToolのライセンスを購入するには、Baslerウェブサイトをご覧ください。
仕組み#
パッケージ上の賞味期限を読み取る場合を想定します。日付は常に同じフォントで印刷され、同じ日付形式を使用します。
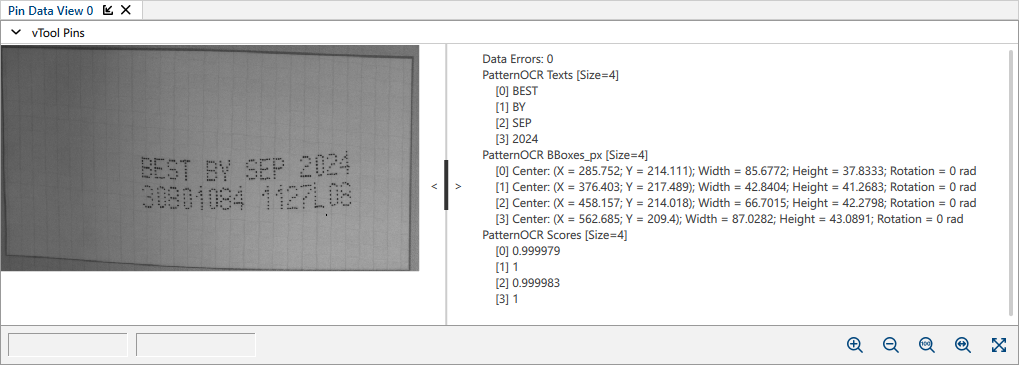
賞味期限やその他の情報を示す入力画像は次のとおりです。
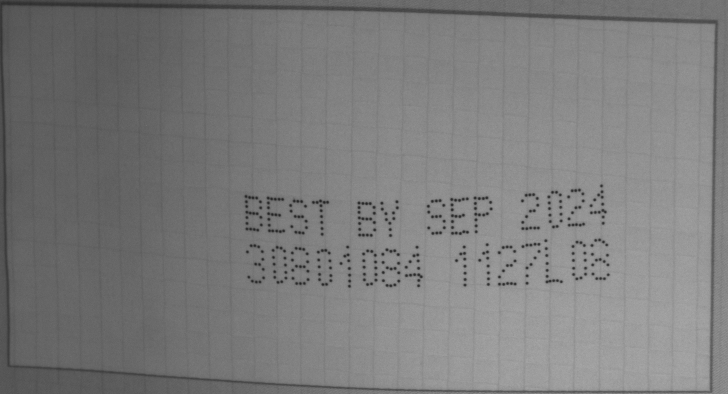
賞味期限を読み取るようにトレーニングされたモデルをロードして、vToolを設定します。
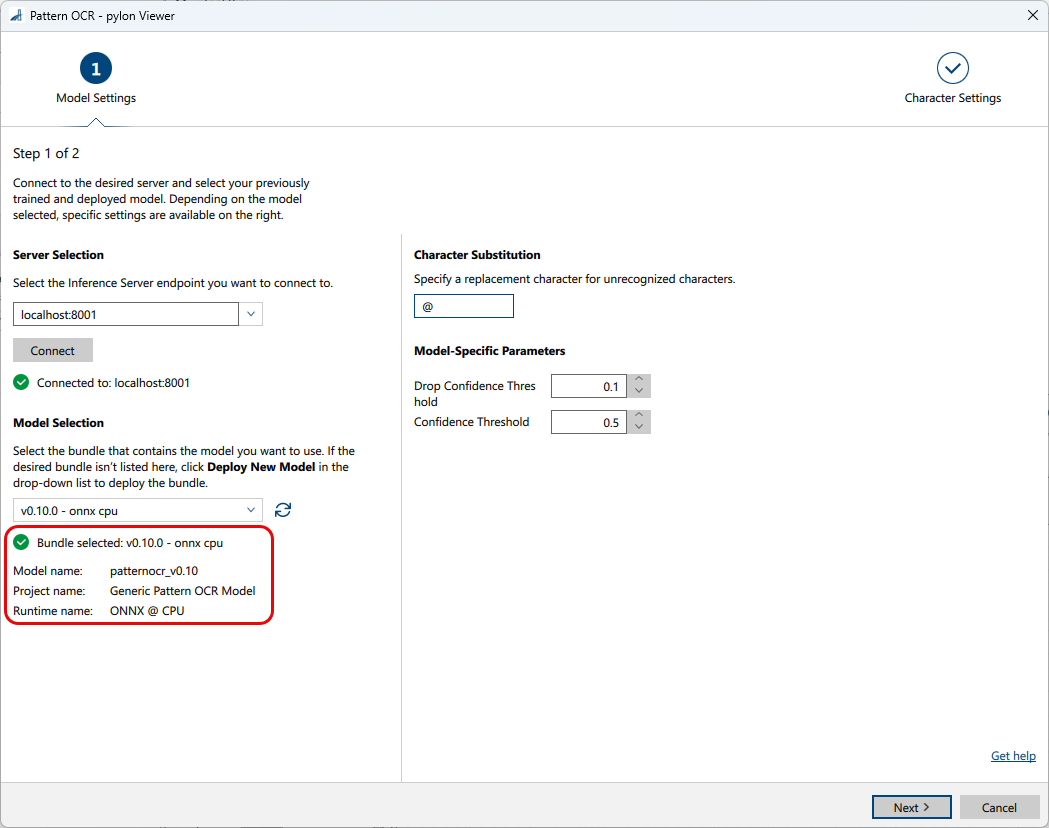
ウイザードの最初のページで、認識されなかった文字の代替として使用される置換文字を指定できます。
設定可能なモデル固有のパラメータを確認することもできます。これらのパラメータは選択したモデルに由来するため、ここでは説明されていません。モデル固有のパラメータの詳細については、Features - Allペインでパラメータを選択し、Feature Documentationペインでその説明を確認してください。
Nextをクリックして、文字設定を構成できるウイザードの2ページ目に進みます。
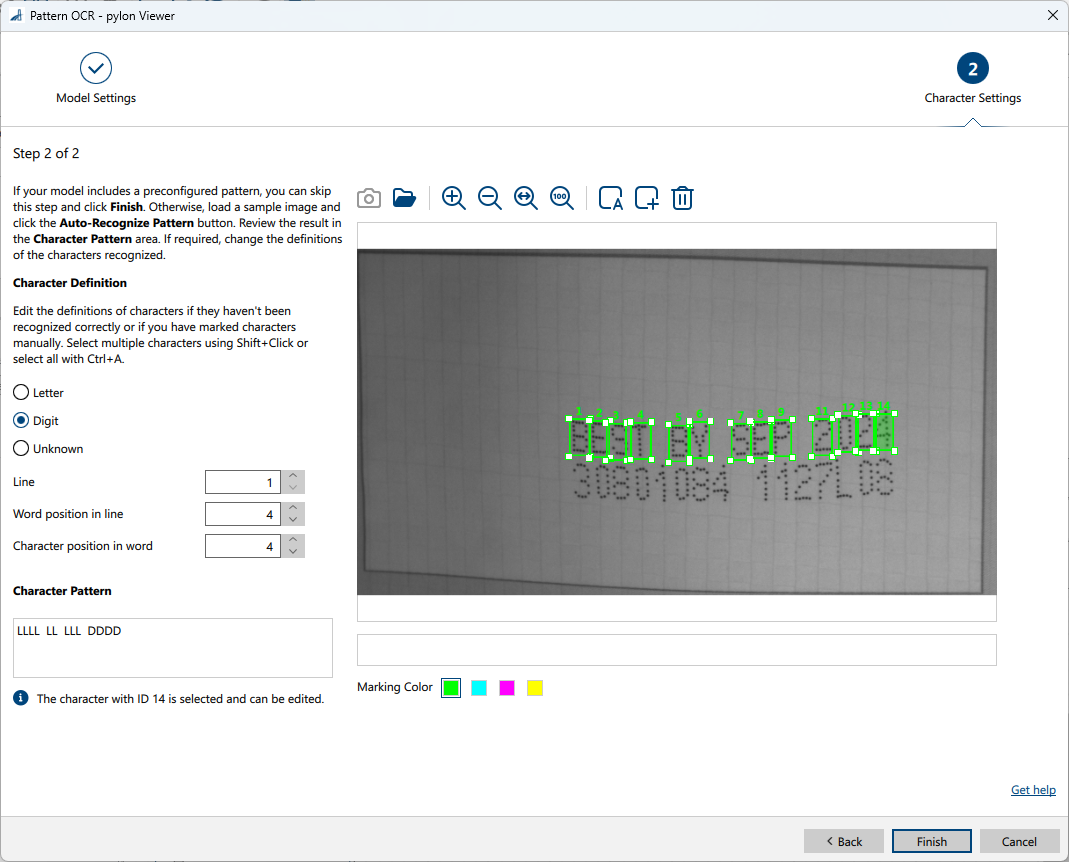
モデルには事前設定されたパターンを含めることができ、これを保持することができます。自分でパターンを定義するには、サンプル画像をロードします。Single Shotを使用して現在の画像をグラブするか、Open Imageを使用して.pngファイルをロードします。Roi入力が接続されている場合、Single Shotはその領域を使用します。回転したROIは、表示される前に真っ直ぐに補正されます。文字マーキングがすでに存在する場合は、別の画像をグラブまたはオープンしたときにそれらを保持するか削除するかを選択します。
各文字を文字(L)、数字(D)、または不明(U)として分類できます。行(1〜10)とその行内の単語の位置(1〜20)を設定します。これらは選択したすべての文字に適用されます。選択した1つの文字に対して、単語内の文字位置(1〜20)を設定します。Shift + 左クリックで複数の文字ボックスを選択するか、Ctrl+Aですべてを選択します。行、単語の位置、および文字の位置の各組み合わせが一意である必要があります。エディターは重複する定義を報告します。
パターンを作成する最も簡単な方法は、Auto-Recognize Patternボタンを使用することです。

Auto-recognizeでは、パターンにいくつの行が含まれているかを尋ねられます。1から20までの値を入力してください。見つかった各文字の周囲に枠が配置され、それに応じて文字の定義が更新されます。すでにマーキングが存在する場合は、置き換えられる前に確認してください。文字が見つからない場合、現在のパターンは変更されません。エラーを見つけた場合は、文字ボックスを選択してその定義を変更してください。
文字を手動で定義するには、Mark Character ボタンをクリックします。

これにより、画像に文字ボックスが追加されます。希望の位置にドラッグし、必要に応じて文字定義を編集します。
Character Pattern エリアを使用すると、定義が正しいかどうかを確認できます。
vToolを設定した後、推論プロセスを開始するレシピを実行します。vToolはモデルを使用して画像を分析し、存在する単語やテキストセグメントを読み取ります。分析が完了すると、OCR結果が返されます。
以下は結果を示すピンデータビューです:
画像フォーマット#
モデルに応じて、Image入力ピンで受け付けられる画像タイプは、カラー(BGR 8 Packed)、モノクロ(Mono 8)、またはカラーおよびモノクロ画像となります。
- モデルがカラー画像を想定している場合、カラーのPixel Formatは内部でBGR 8 Packedに変換されます。モノクロ画像は受け付けられません。
- モデルがモノクロ画像を想定している場合、モノクロのPixel Formatは内部でMono 8に変換されます。カラー画像は受け付けられません。
- モデルがモノクロとカラーの両方の画像をサポートしている場合、モノクロ入力はMono 8に変換されてモノクロとして送信され、カラー入力はBGR 8 Packedに変換されてカラーとして送信されます。vToolはカラーをモノクロに、またはモノクロをカラーに変換しません。
入力された Pixel Format がサポートされていない場合は、まず Image Format Converter vTool を使用して画像を変換してください。カラー入力には BGR 8 Packed、モノクロ入力には Mono 8 を選択します。
出力データマッピング#
Texts、BBoxes_px、および Scores の結果は、インデックスが一致する配列として出力されます。出力内の同じ位置にある要素は、同じテキストセグメントを指します。vTool による追加のソートは適用されません。
モデルの出力順序やセグメンテーションが異なる場合、出力ピンはモデルの出力順序を維持します。
例:
3つの要素(認識されたテキストセグメント)を持つ出力データ配列
Texts: ["AB", "12045", "XZ"]
Scores: [0.98, 0.95, 0.93]
BBoxes_px: [b0, b1, b2]
ここでは、インデックス 0 は要素/テキストセグメント 1 に、インデックス 1 は要素/テキストセグメント 2 に、インデックス 2 は要素/テキストセグメント 3 に対応します。
vToolの設定#
Pattern OCR vToolを設定するには:
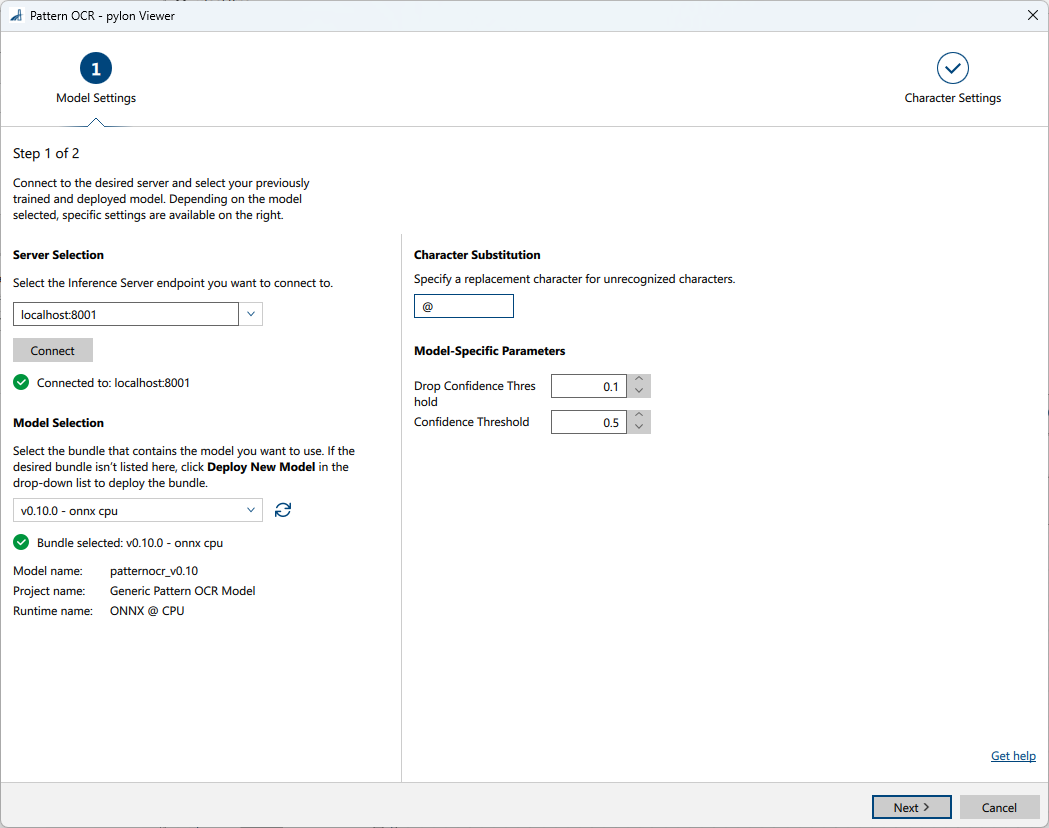
-
vTool Settings エリアの Recipe Management ペインで、Open Settings をクリックするか、vToolをダブルクリックします。
すると、Pattern OCR ダイアログが開きます。 -
Server Selection エリアで、接続するサーバーを選択します。
接続するには、サーバーが実行されている必要があります。- オプション1:Triton Inference ServerのIPアドレスとポートを手動で入力します。
- オプション2:ドロップダウンリストからサーバーのIPアドレス / ホスト名とポートを選択します。
-
Connectをクリックして接続を確立します。
その後、vToolによって利用可能なモデルがロードされます。 -
ペインの モデルの選択 エリアで、ドロップダウンリストから目的のモデルが含まれるバンドルを選択します。
バンドルを選択すると、ドロップダウンリストの下部にバンドルの詳細情報が入力され、正しいバンドルを選択したかどうかを確認できます。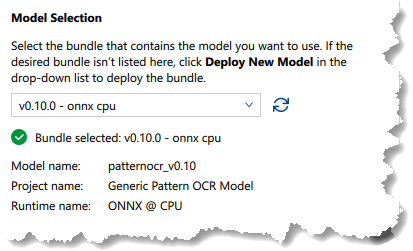
-
目的のバンドルが表示されない場合は、次をクリックします 新しいモデルのデプロイ ドロップダウンリストで。
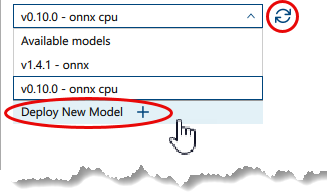
これにより、次が開きます pylon AI Agent さらにモデルをデプロイできるようになります。
新しいモデルをデプロイした後は、次をクリックする必要があります 更新 ボタン。 -
代替文字を指定するか、デフォルトの文字をそのまま使用します。
-
モデル固有のパラメータを指定します。
情報
このエリアで利用可能なパラメータは、選択したモデルによって異なります。一部のパラメータは、特定のモデルを選択した後にのみ利用可能になります。デフォルト値はモデルによって提供されます。
-
クリック Next.
イメージ Character Settings ページが開きます。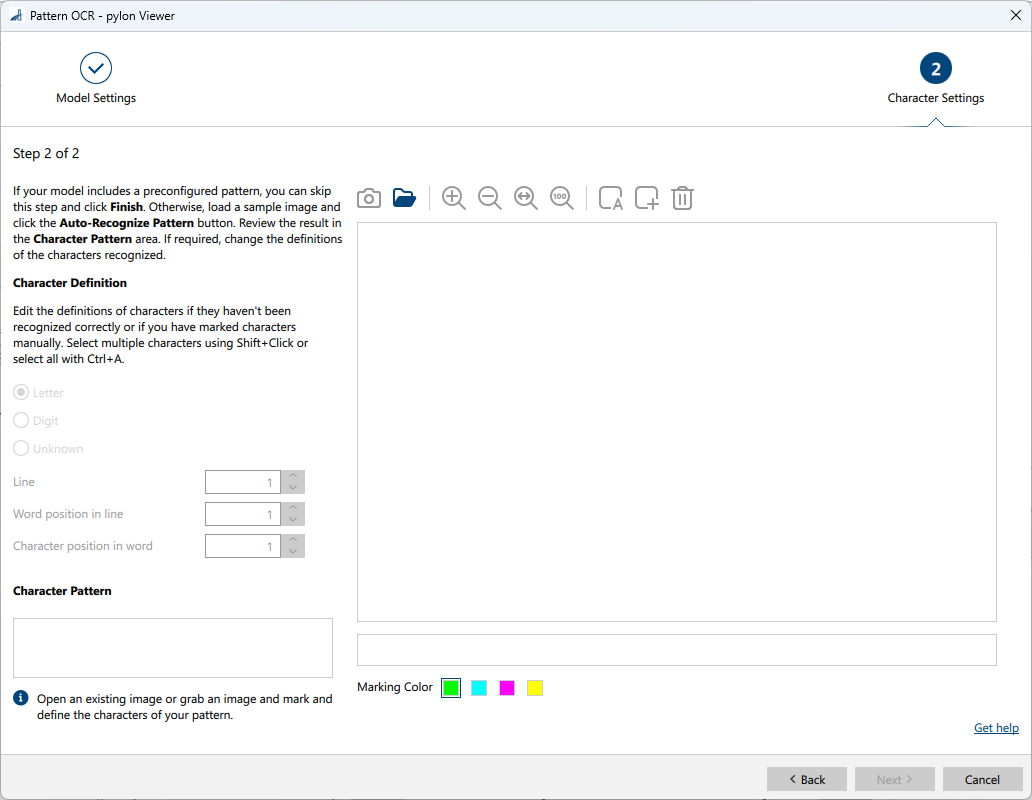
- Character Settings ページで、モデルにあらかじめ設定されたパターンが含まれている場合は、そのパターンを確認します。
モデルにあらかじめ設定されたパターンが含まれていない場合は、Single Shot でサンプル画像を撮影するか、Open Image を使用して既存の画像を開きます。Auto-Recognize Pattern を使用するか、文字を手動でマーキングしてパターンを定義します。 - Character Pattern エリアでパターンを確認します。
- Finish をクリックします。
Pattern OCR vToolの結果は、ピンデータビューで確認できます。ここで、表示する出力を選択できます。
入力#
画像#
Camera vToolから、またはImage Format ConvertervToolなどの画像を出力するvToolから、直接画像を受け入れます。
- データ型:Image
- 画像フォーマット:モノクロ画像またはカラー画像。サポートされている Pixel Format は、モデルに応じて内部で Mono 8 または BGR 8 Packed に変換されます。詳細については、Image Formats を参照してください。
Roi#
ROI Creator vToolまたは長方形を出力するその他のvToolから、1つの関心領域(ROI)を受け入れます。
ROIが画像と重なっていない場合、または画像内のエリアが1×1ピクセル以下の場合、vToolは推論サーバーを呼び出すことなく、空の Texts、Scores、および BBoxes_px 配列を返します。これには、何も選択されていない場合のROI Creatorのデフォルトが含まれます。
ROIが回転している場合、推論の前に真っ直ぐに補正されます。長方形の内側の領域が入力画像から切り抜かれ、軸に平行になるように回転されます。この真っ直ぐにされた切り抜き画像が推論に入力されます。
結果として得られるバウンディングボックスは逆変換され、元の入力画像の座標系で軸に平行な長方形として返されます。位置、幅、高さは、切り抜かれた領域ではなく、常に入力画像を参照します。
- データタイプ:RectangleF
出力#
Texts、BBoxes_px、および Scores の結果は、インデックスが一致する配列として出力されます。出力内の同じ位置にあるアイテムは、同じテキストセグメントを指します。
入力が無効であるか、処理が失敗した場合、有効化された各出力はエラーの理由とともに無効な値を返します。
テキスト#
検出された各単語またはテキストセグメントを返します。認識されなかったテキストは、代替文字を使用して返されます。
- データ型:String Array
BBoxes_px#
すべてのテキストセグメントに対して軸に平行なバウンディングボックスを返します。各ボックスは、そのセグメント内の文字ボックスの和集合であり、中心ピクセルの座標、幅、高さ(x_center、y_center、width、height)によって定義されます。セグメント内のアンダースコア文字(_)は、和集合から除外されます。
座標は、Roi 入力ピンが接続されている場合を含め、元の入力画像を参照します。ROIが回転している場合、ボックスはその画像内で軸に平行な長方形としてマッピングされます。バウンディングボックスの出力は、他のvToolsの Roi 入力ピンへの入力として使用できます。
- データ型:RectangleF Array
スコア#
認識された各テキストセグメントの信頼度スコアを返します。値が高いほど、信頼度が高いことを示します。セグメントスコアは、そのセグメント内で認識された文字スコアの算術平均です。文字スコアが設定されたしきい値を下回り、文字が設定された Character Substitution の値に置き換えられた場合でも、その文字位置は元の文字スコアとともにこの平均に含まれます。
0以下のスコアは次のように返されます: 0.0.
- データ型:Float Array
ペイロード#
評価用にインファレンスサーバーのパフォーマンスに関する追加情報を返します。この出力ピンは、Debug Settingsパラメータグループ内のFeatures - Allペインで有効にした場合にのみ使用可能になります。
- データタイプ:文字列