pylon AIの使用開始#
pylon AIを使用するには、次のコンポーネントをインストールする必要があります。
- pylon Software Suite
- pylon AI用pylon補助パッケージ
補助パッケージのインストールについては、このトピックで説明します。 - また、使用するvToolsのライセンスも必要です。ライセンスの取得およびアクティベーション方法については、vToolライセンスのトピックを参照してください。
pylon AI用pylon補助パッケージは、AI vToolsがディープラーニングモデルを実行できるようにするバックエンドサービスを提供します。このバックエンドサービスは、モデルの暗号化とライセンスをサポートするBaslerアドオンを備えたNVIDIA Triton Inference Serverです。
これは、開発環境におけるTriton Inference Serverの位置づけの概要です。
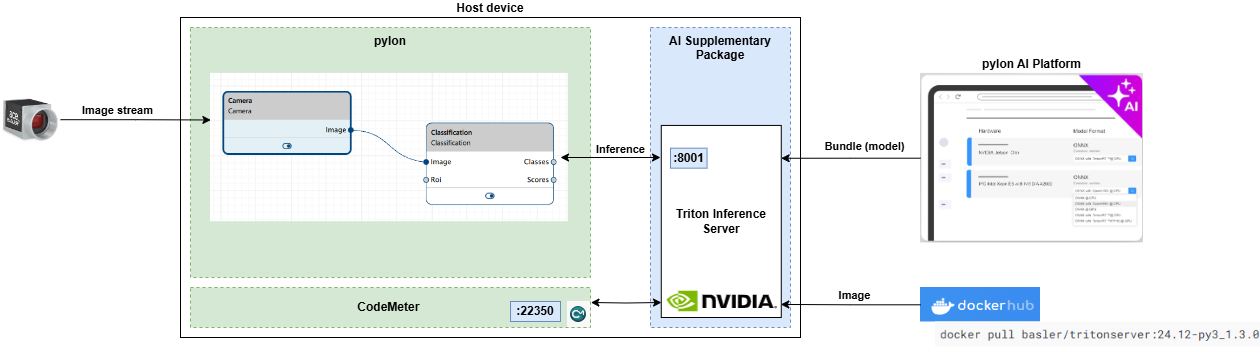
Triton Serverのインストール方法には、次の2つのオプションがあります。
- ローカルコンピューター上
- ネットワーク上のリモートコンピューター上
1番目のオプションはご自身のプロジェクトで単独で作業する場合に推奨され、2番目のオプションはチームで作業する場合に適しています。
Baslerは、稼働中のTritonサーバーインスタンスを提供しておらず、サーバーをパブリックなインターネットエンドポイントとして公開することを推奨していません。常に開発環境の一部と見なし、それに応じて保護する必要があります。
pylon AI用pylon Supplementary Packageには、pylon AI vToolsおよびpylon AI Agentで使用できるようにTriton Inference Serverを準備するための変更済みDockerイメージが含まれています。また、セットアップおよび起動スクリプトのほか、リリースノートやサードパーティ製ライセンスの情報も含まれています。
システム要件#
UbuntuおよびUbuntu for WSL#
- x86_64 CPU:最新のIntel Core i5(またはそれ以降)または同等のもの。
- Memory:利用可能なRAMが最低8 GB必要です。16 GB以上の利用可能なRAMを推奨します。
- ディスクタイプ:SSDをお勧めします。
- ディスク空き容量:インストールには最低20 GBの空きディスク容量が必要です。モデルリポジトリに必要な容量は、導入予定のモデルのサイズと数によって異なります。モデルのサイズは、1つあたり数MBから数GBまでさまざまです。
- CUDAバージョン:12以降
- GPUカード:適したカードの例として、NVIDIA RTX A5000、NVIDIA RTX A2000 Laptop GPU、NVIDIA Tesla T4などが挙げられます。
情報
Triton Inference Serverの実行にはCPUでも十分です。より高速なパフォーマンスが必要な場合は、GPUの使用をお勧めします。
JetPack 6搭載Jetsonファミリ#
- モジュール:すべての NVIDIA Jetson
- Memory:利用可能なRAMが最低8 GB必要です。16 GB以上の利用可能なRAMを推奨します。
- ディスクタイプ:SSDをお勧めします。
- ディスク空き容量:インストールには最低20 GBの空きディスク容量が必要です。モデルリポジトリに必要な容量は、導入予定のモデルのサイズと数によって異なります。モデルのサイズは、1つあたり数MBから数GBまでさまざまです。
前提条件#
情報
-
インストールのプロセス中はインターネット接続が必要です。
-
ローカルコンピューター上で、ポート8000、8001、8002、22350がブロックされていないことを確認してください。
お客様側の環境におけるシナリオの多様性と複雑さのため、Baslerでは一般的な解決策を提供することができません。したがって、潜在的なアクセス問題については、お客様ご自身の責任において、IT部門のサポートを受けながら対処していただく必要があります。
Ubuntu#
詳細については、install docker on Ubuntuを参照してください。
お使いのコンピューターにNVIDIA GPUが搭載されている場合は、Installing NVIDIA drivers and the NVIDIA Container Toolkitを参照してください。
Ubuntu for WSL#
情報
WSL内にLinuxのディスプレイ・ドライバーをインストールしないでください。ドライバーはWindows上に直接インストールする必要があります。
次の手順に従って、Ubuntu OS on WSLをインストールします。
次の手順に従って、Docker within Ubuntu on WSLをインストールします。
Jetsonファミリ(JetPack 6.x)#
SDK Managerを使用してデバイスにフラッシュ書き込みを行う必要があります。JetPack 6.xが必要です。これにはすでにDockerが含まれています。
すべてのOSバリエーション#
オペレーティングシステムの準備が整ったら、以下の要件を満たしていることを確認してください。
- CodeMeter Runtimeがインストールされていること。
CodeMeter Runtimeのインストールは、pylon Software Suiteのインストールに含まれています。 - AI vToolsのライセンスが利用可能であること。
詳細については、Baslerウェブサイトをご覧ください。 -
Docker Engineがインストールされていること。
Docker Engineがインストールされているか確認するには: -
GPUを使用する場合:NVIDIA Container Toolkitがインストールされていること。
このツールキットがインストールされているか確認するには:まだインストールされていない場合は、次のセクションをお読みください。
NVIDIAドライバおよびNVIDIA Container Toolkitのインストール(GPUの使用に必須)#
NVIDIA Container Toolkitは、GPUアクセラレーテッド・コンピューティングに必要なライブラリとツールを提供します。Triton Inference ServerはCUDAを使用して、モデル推論などのGPUアクセラレーテッド演算を実行します。NVIDIA Container Toolkitのバージョンは、Triton Serverおよび導入するモデルが要求するバージョンと一致している必要があります。
NVIDIAドライバーのバージョンを確認するには、ターミナルを開いて次のコマンドを入力します:
ドライバーやツールキットがまだインストールされていない場合は、このページの指示に従ってください:https://docs.nvidia.com/datacenter/cloud-native/container-toolkit/latest/install-guide.html
お使いのNVIDIAドライバーがNVIDIA Container ToolkitおよびTriton Inference Serverと互換性があることを確認するには、このページをご確認ください:https://docs.nvidia.com/deeplearning/triton-inference-server/release-notes/rel-24-11.html#rel-24-11
Triton Inference Serverのインストール#
モデルリポジトリは、インストールのプロセスの一環としてホームディレクトリ内に作成されます(例:/home/username/pylon_ai/model_repository)。これを変更してはなりません。
オンラインインストール#
pylon Supplementary Package for pylon AIからTriton Inference Serverをインストールするには、以下の手順に従います:
- Baslerウェブサイトからダウンロードしたpylon-supplementary-package-for-pylon-ai-*.tar.gzアーカイブが含まれているディレクトリに移動します。
-
pylon AI用 pylon 補足パッケージの tar.gz アーカイブを任意のディレクトリに展開します(別のディレクトリに展開する場合は、./pylon_ai_setup を置き換えてください)。
-
pylon AI用 pylon 補足パッケージを展開したフォルダに移動します。
-
root権限でセットアップスクリプトを実行します。
オフラインインストール#
インターネット接続を利用できない場合は、次の手順に従ってください。
- インターネットに接続されているコンピュータで dockerhub にアクセスし、Basler Triton Server Docker イメージをダウンロードします。
イメージは次のリンクから入手できます:https://hub.docker.com/repository/docker/basler/tritonserver/general -
Triton Server をインストールするコンピュータにイメージを転送します。
次のコマンドを使用して、手順 1 および 2 を実行できます。例:
-
Baslerウェブサイトからダウンロードしたpylon-supplementary-package-for-pylon-ai-*.tar.gzアーカイブが含まれているディレクトリに移動します。
-
pylon AI用 pylon 補足パッケージの tar.gz アーカイブを任意のディレクトリに展開します(別のディレクトリに展開する場合は、./pylon_ai_setup を置き換えてください)。
-
保存した .tar ファイルを pylon_ai_setup フォルダにコピーします。
-
root権限でセットアップスクリプトを実行します。
Triton Inference Serverの起動#
このセクションでは、Inference Server を起動する 3 つの方法について詳しく説明します。サーバーと vTools のリモート実行に関する以下の情報を念頭に置いて、ニーズに最も適した方法を選択してください。
Inference Server を起動すると、サーバーはモデルリポジトリがデフォルトの場所(/home/username/pylon_ai/model_repository)にあるものと想定します。誤ってリポジトリの名前を変更または削除した場合は、サーバーを再インストールしてリポジトリを再作成する必要があります。
サーバーと vTools のリモート実行
リモートコンピュータで Triton Inference Server を実行しており、かつ別の場所から AI vTools または AI Agent も実行している場合は、以下の重要な制限事項と考慮事項に注意してください。
- 推論リクエストを行うvToolとTriton Inference Serverの間でデータが転送されるのにかかる時間は、全体的な応答時間に影響を与える可能性があります。
- 高遅延は、特にリアルタイムアプリケーションにおいて、推論プロセスを遅くする原因となります。
- 限られたネットワーク帯域幅は、特に大量のデータを転送する際に、通信の遅延や不安定さを引き起こす可能性があります。
- リモート機能を使用するには、ポート 8000、8001、8002 にアクセスできる必要があります。(これには、ファイアウォールやプロキシのチェックの実行など、IT 部門からのサポートが必要になる場合があります。)
必要なときのサーバーの起動#
コンピュータの起動時に Triton Inference Server を Docker コンテナとして起動しない場合は、必要なときに次のシェルスクリプトを使用して Triton Inference Server を起動できます。
- pylon AI用 pylon 補足パッケージを展開したフォルダに移動します。
-
Triton Inference Server を起動します。
起動時のサーバーの自動起動#
コンピュータの起動時に Triton Inference Server の Docker コンテナを自動的に起動したり、クラッシュ時に自動的に再起動したりするようにするには、「run-pylon-ai-triton-inference-server.sh」シェルスクリプトに追加のパラメータを指定して実行し、ニーズを満たす systemd サービスを作成します。
- pylon AI用 pylon 補足パッケージを展開したフォルダに移動します。
-
インストーラースクリプトを起動します。
Triton Inference Server をサービスとしてインストールした後は、必要に応じて一時的に停止できます。デバイスの再起動後に自動的に起動することに注意してください。
Triton Inference Server の実行を担当する systemd サービスを一時的に停止するには、(任意のディレクトリで)ターミナルを開き、次を実行します。
サービスを復元する場合は、次を実行して起動する必要があります。
サービスによって管理されている現在実行中のサーバーに問題がある場合は、次を実行して再起動できます。
サービスを完全に無効にする場合は、次を実行して行うことができます。
ライセンス#
ライセンス情報については、こちらまたは pylon AI 用 pylon 補足パッケージに含まれるライセンスファイルを参照してください。
トラブルシューティング#
Triton Inference Server が必要なライセンスにアクセスできるように、pylon のインストール時に CodeMeter が設定されます。
まれに、これが失敗することがあります。その場合は、CodeMeter をネットワークサーバーとして設定してください。
- CodeMeter Control Center を開き、右下の WebAdmin ボタンをクリックします。
- CodeMeter WebAdminで、Configuration > Server > Server Accessの順に移動します。
- Network Serverエリアで、Enableを選択し、Applyで確定します。
- CodeMeter Control Centerに戻ります。
- ProcessメニューでRestart CodeMeter Serviceをクリックし、CodeMeterをネットワークサーバーとして再起動します。
Known Issues#
Jetson OrinでのONNX Runtimeエラー
デバイスが低電力モードで動作している場合、Jetson Orinデバイスで次のコマンドを実行すると run-pylon-ai-triton-inference-server.sh ランタイムエラーが表示されます。ただし、読み込もうとしたモデルは引き続き読み込まれます。このエラーを防ぐには、Jetson Orinでより高い電力モードを設定してください。