Semantic Segmentation vTool#
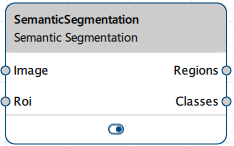
のSemantic Segmentation vToolは、 Image入力ピンを介して受信した画像内のオブジェクトを分類できます。分類結果は、 Regions出力ピンとClasses出力ピンを介して出力されます。
同じクラスの個別のインスタンスを互いに区別したい場合は、 Instance Segmentation vTool使用してください。
使用する場合はROI Creator vTool セグメンテーションの前に関心領域を指定するには、 Semantic Segmentation vToolはROI入力ピンを介してROIデータを受け取ります。この場合、セグメンテーションは関心領域のみに対して実行されます。副次的な効果として、処理速度が向上します。
ライセンスを購入するにはSemantic Segmentation vTool については、 Basler Web サイトにアクセスしてください。
仕組み#
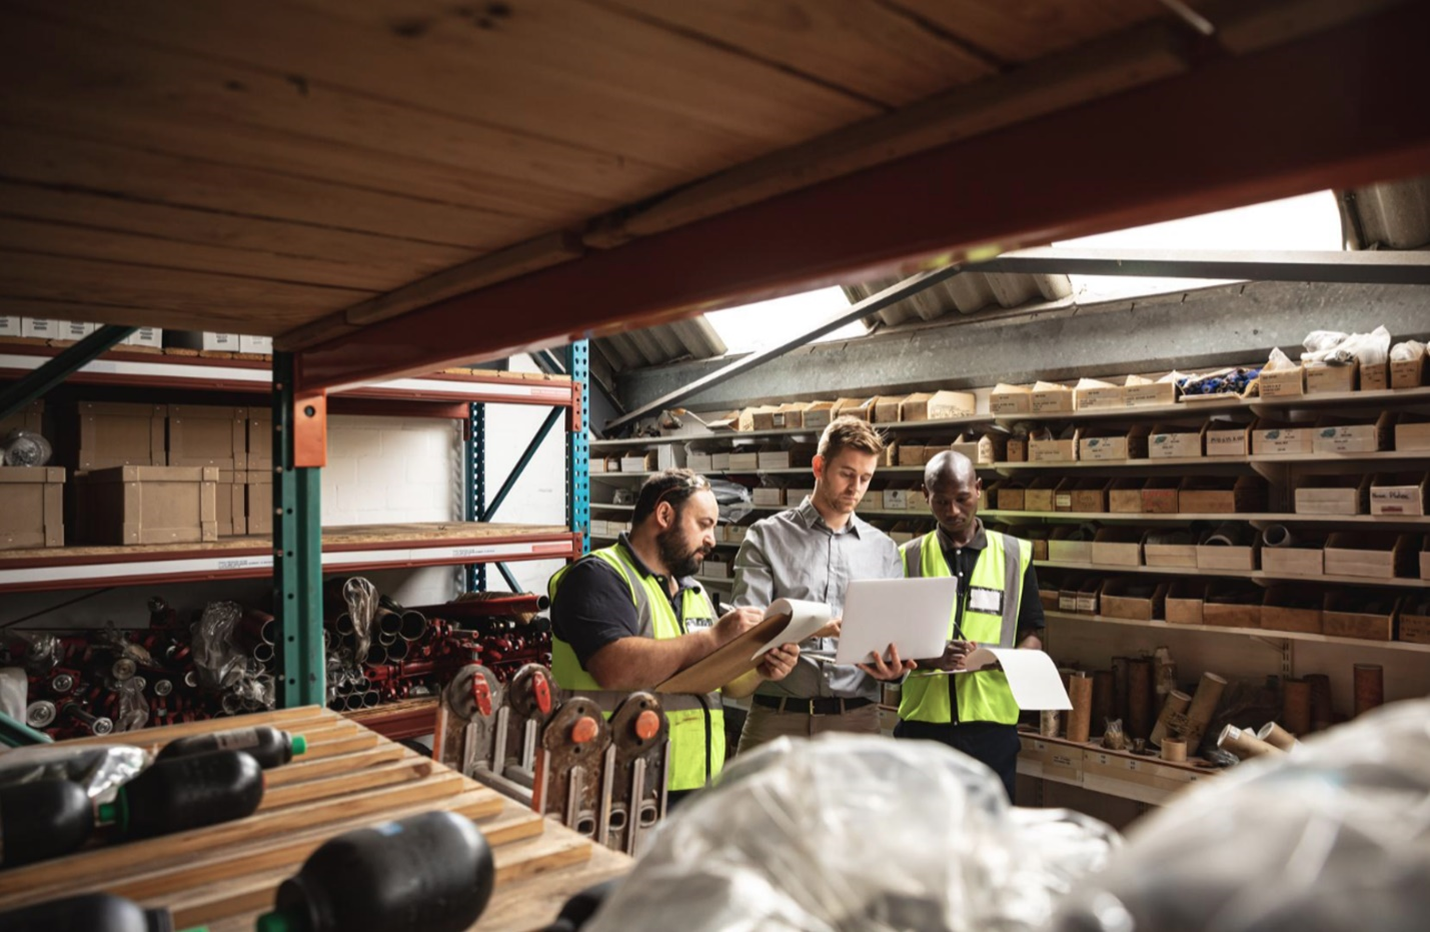
画像内の人物を識別し、背景から区別してセグメント化したいと仮定します。
これは、倉庫のような環境で3人の人物が写っており、背景には様々な機器が写っている入力画像です。
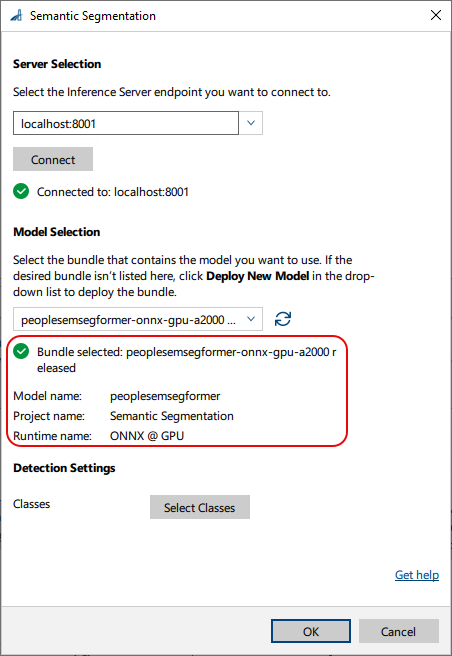
vToolを設定するには、画像を人物と背景の2つのクラスにセグメント化するようにトレーニングされたモデルをロードします。
次に、検出およびセグメント化するクラスを選択できます。モデルによっては、お客様の用途に合わせて正確に調整されている場合があります。その場合、目的のクラスはすべてすでに選択されています。

vToolの設定後、推論プロセスを開始するレシピを実行します。vToolはモデルを使用して画像を分析し、存在するオブジェクトをセグメント化します。分析が完了すると、セグメンテーション結果、つまり領域とクラスが返されます。
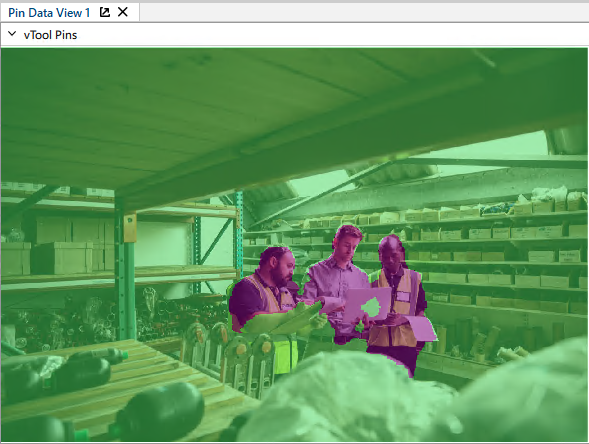
これは、ピンデータビューで表示された結果画像で、元の画像は表示されず、セグメント化された領域のみが表示されています。
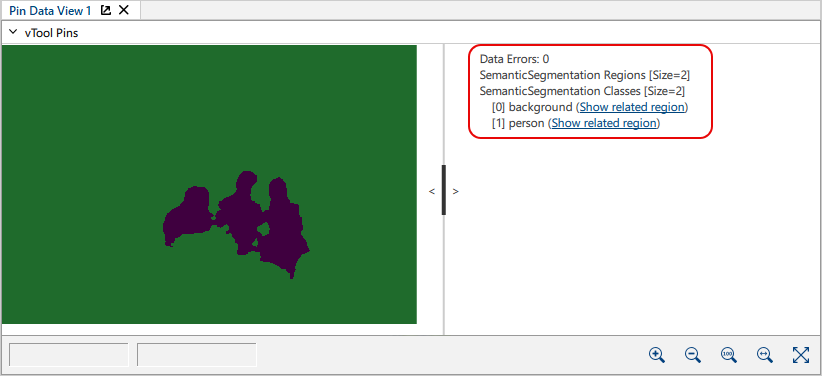
ピンデータビューで入力画像を有効にすると、セグメント化された領域が元の画像に重ねて表示されます。これにより、元の画像と検出された領域を同時に確認できます。
詳細出力
領域:vToolは、モデルが画像内で人物を検出した領域を強調表示します。出力画像では、人物は背景から明確に分離され、通常は異なる色で表示されます(この例では、人物は紫、背景は緑)。
クラス: 背景、人物
vToolの設定#
設定するにはSemantic Segmentation vTool:
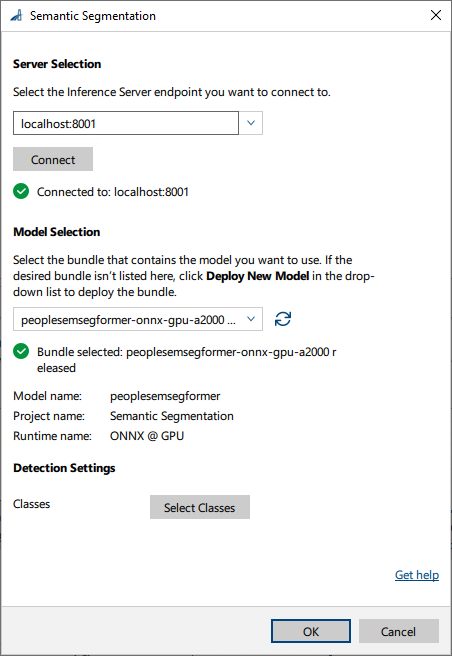
- vTool設定領域のレシピ管理ペインで、 [設定を開く]をクリックするか、vToolをダブルクリックします。
Semantic Segmentationダイアログが開きます。 - ペインの Server Selection エリアで、接続するサーバーを選択します。
接続するには、サーバーが実行されている必要があります。- オプション1:Triton Inference ServerのIPアドレスとポートを手動で入力します。
- オプション2:ドロップダウンリストからサーバーのIPアドレス/ホスト名とポートを選択します。
- Connectをクリックして接続を確立します。
その後、vToolは利用可能なモデルをロードします。 - ペインの Model Selection エリアで、ドロップダウンリストから目的のモデルが含まれるバンドルを選択します。
バンドルを選択すると、ドロップダウンリストの下部にバンドルの詳細情報が入力され、正しいバンドルを選択したかどうかを確認できます。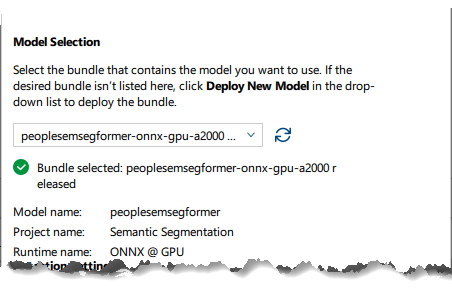
- 目的のバンドルがリストにない場合は、クリックします Deploy New Model ドロップダウンリスト内。
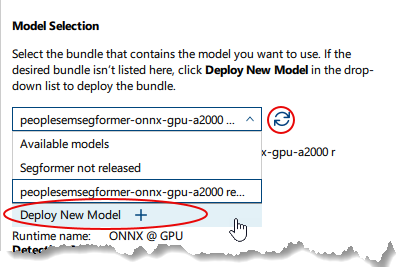
これにより以下が開きます pylon AI Agent さらにモデルをデプロイできるようになります。
新しいモデルをデプロイした後は、次をクリックする必要があります 更新 ボタン。 -
Detection Settingsエリアで、Select Classesをクリックして、分類するクラスを選択します。
利用可能なクラスが表示されたダイアログが開きます。デフォルトではすべてのクラスが選択されています。必要な数のクラスを選択できます。情報
このエリアで利用可能なパラメータは、選択したモデルによって異なります。一部のパラメータは、特定のモデルを選択した後にのみ利用可能になります。デフォルト値はモデルによって提供されます。
-
OKをクリックします。
セグメンテーションの結果は、pin data viewで確認できます。ここでは、表示する出力項目を選択できます。
入力#
画像#
Camera vToolから、またはImage Format ConvertervToolなどの画像を出力するvToolから、直接画像を受け入れます。
- データ型:Image
- 画像形式:8ビットから16ビットのカラー画像
Roi#
ROI Creator vToolや長方形を出力するその他のvToolから関心領域を受け取ります。複数の長方形が入力された場合、最初の長方形が単一の関心領域として使用されます。
- データ型:RectangleF、RectangleF Array
出力#
領域#
クラスラベルごとに領域を返します。
- データ型:Region Array
クラス#
予測されたクラスラベルを返します。
- データ型:String Array
ペイロード#
評価用のInference Serverのパフォーマンスに関する追加情報を返します。この出力ピンは、Debug SettingsパラメータグループのFeatures - Allペインで有効にした場合にのみ利用可能になります。
- データタイプ:文字列