pylon AI Agent#
DLモデルは、ハードウェア構成などとともにバンドルにパッケージ化され、pylon AI Platformを介してリリースされます。リリース後、pylon AI Agentを使用してTriton Inference Server上のpylon AI vTools用モデルをデプロイします。
Triton Inference Serverは推論プロセスを処理します。ディープラーニングの文脈において、推論とは、トレーニング済みのモデルを新しく未知のデータに適用し、その内容について予測を行うことを意味します。
pylon AI Agentの概要#
AI Agentを起動するには、次の2つの方法があります。
- pylon ViewerのWorkbenchメニューから
- vToolの設定ダイアログから
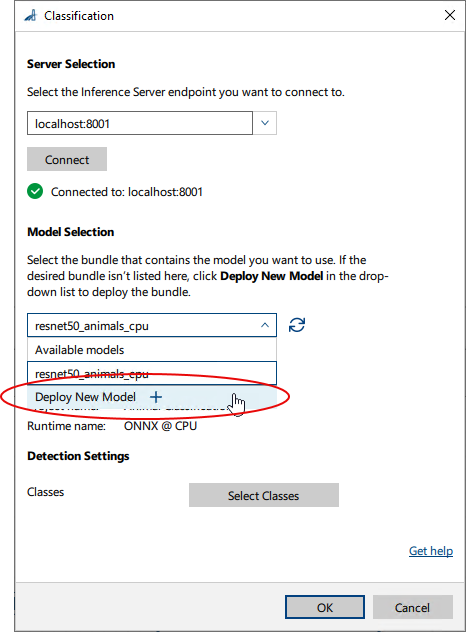
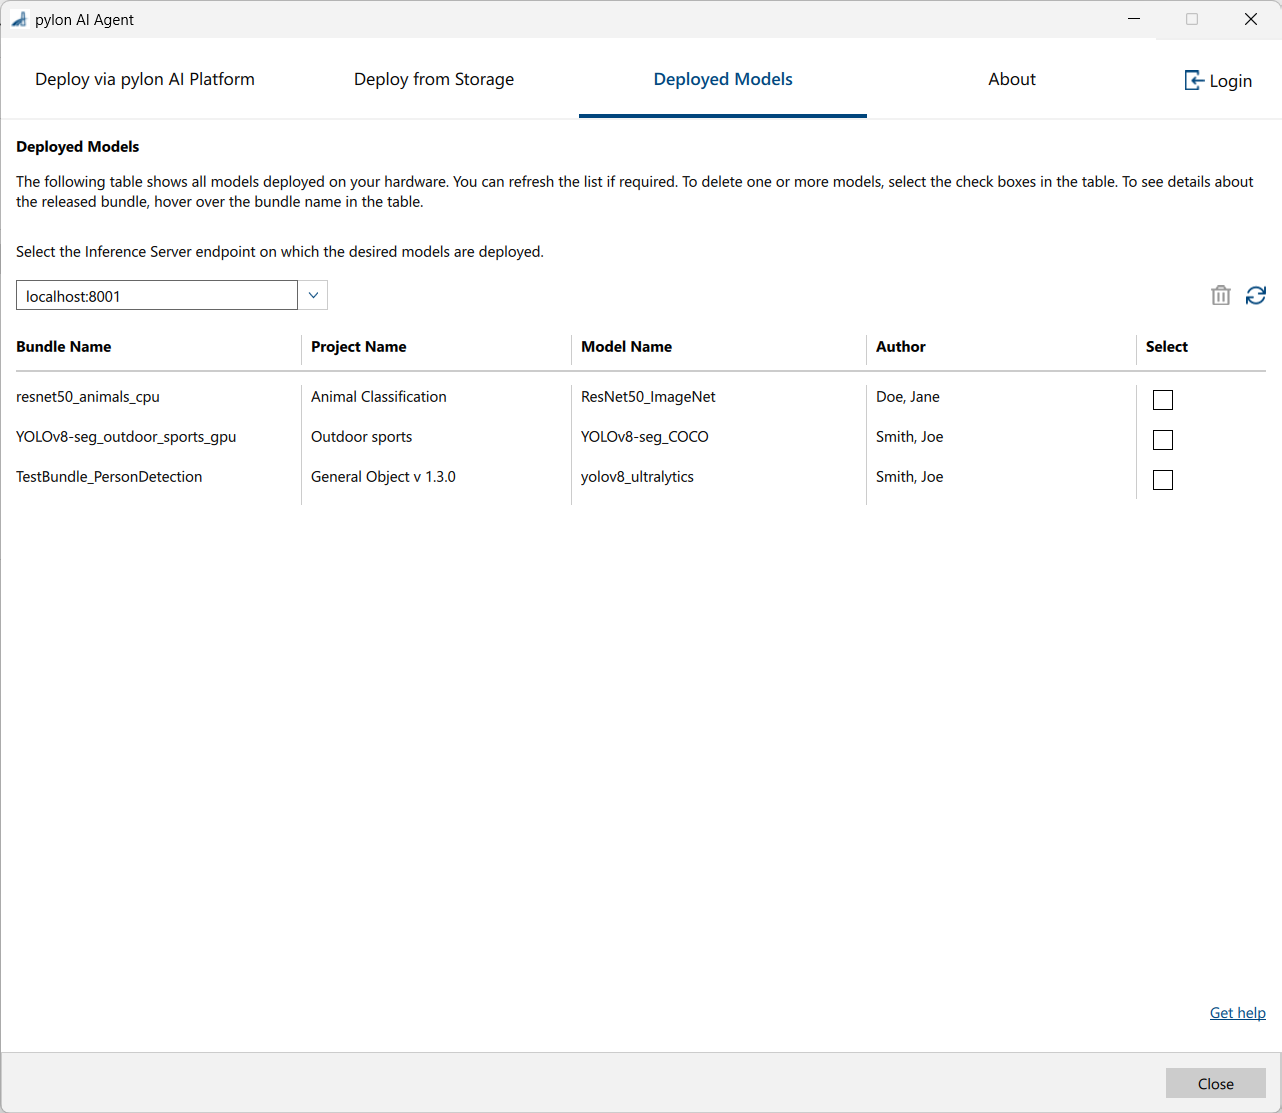
どちらの方法でも、AI AgentがDeployed Modelsタブで開きます。ここでは、すでにデプロイされているモデルを確認できます。
モデルをデプロイするには、pylon AI Platform経由のデプロイ、またはハードドライブやフラッシュドライブなどのストレージからのデプロイを選択できます。
pylon AI Platform経由でのデプロイ#
pylon AI Platform経由でモデルをデプロイする場合は、以下の点に注意する必要があります。
-
AI Agentを以下のメニューから開いた場合 Workbench すべてのビジョンタスクで使用可能なすべてのモデルが表示されます。 pylon AI Platform経由でのデプロイ タブ。
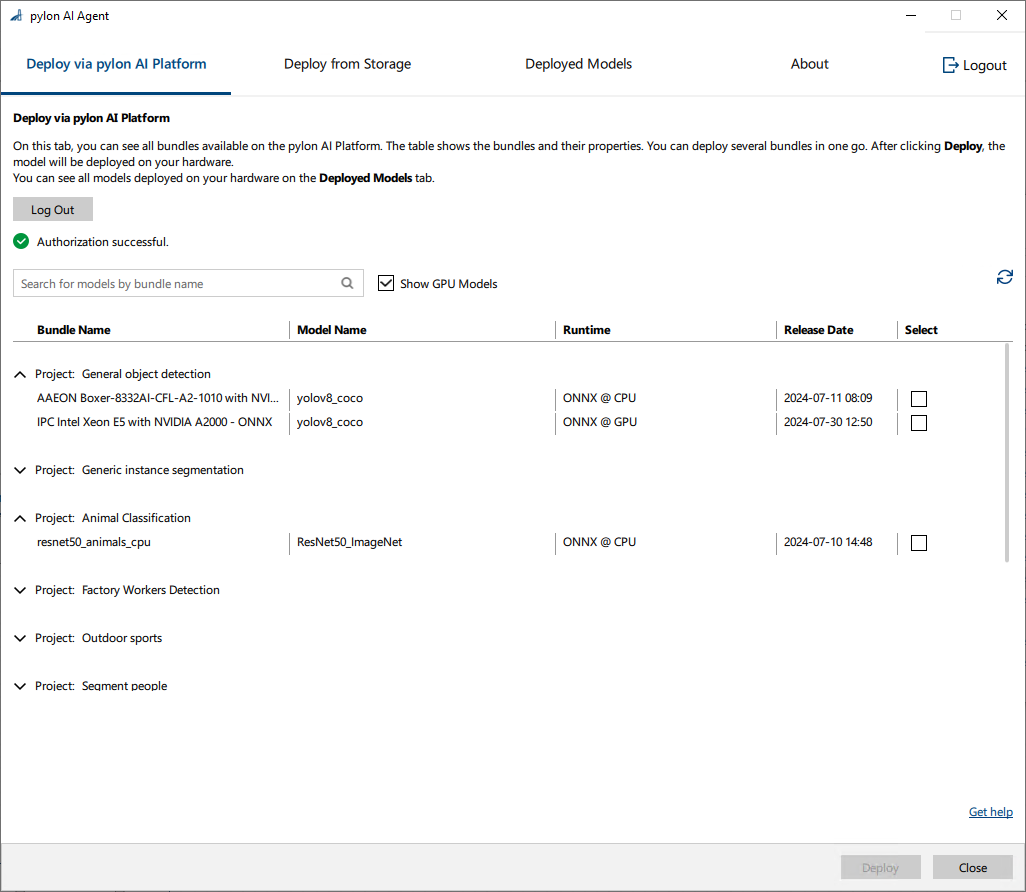
-
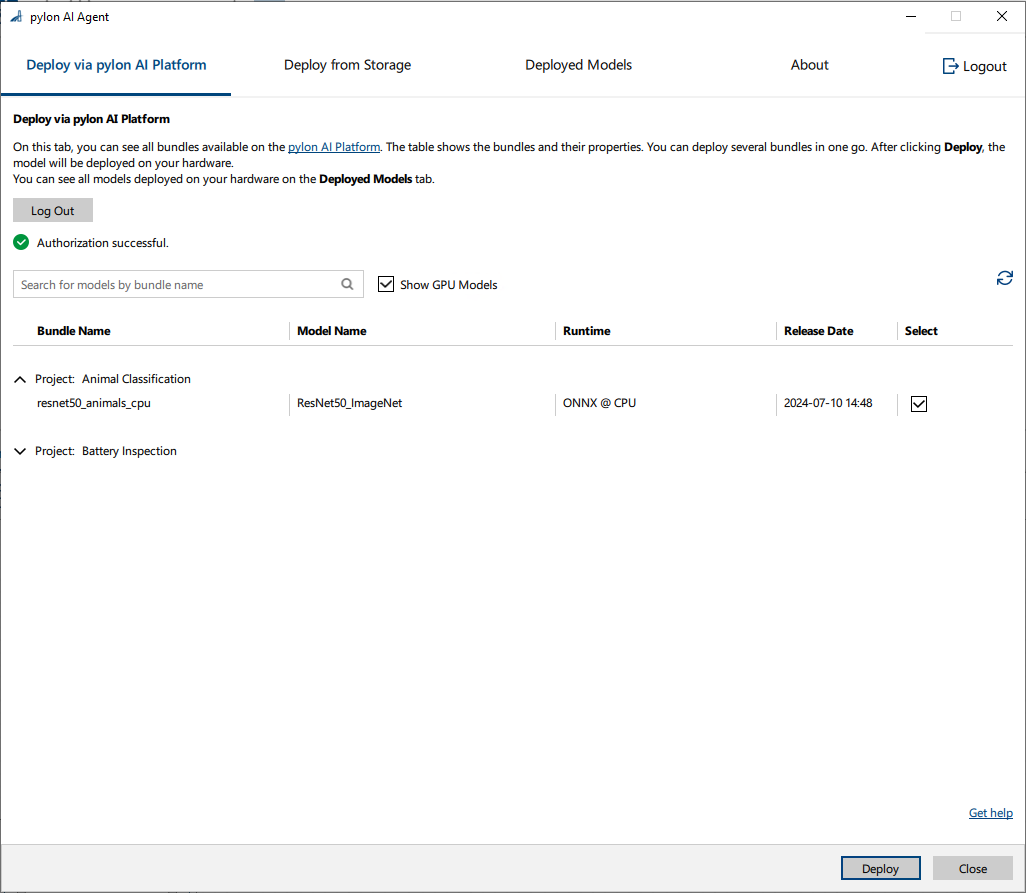
vToolの設定ダイアログからAI Agentを開いた場合、現在設定しているvToolに適したモデルのみが表示されます。次のスクリーンショットでは、Classification vToolの設定ダイアログからAI Agentが開かれています。
ストレージからのデプロイ#
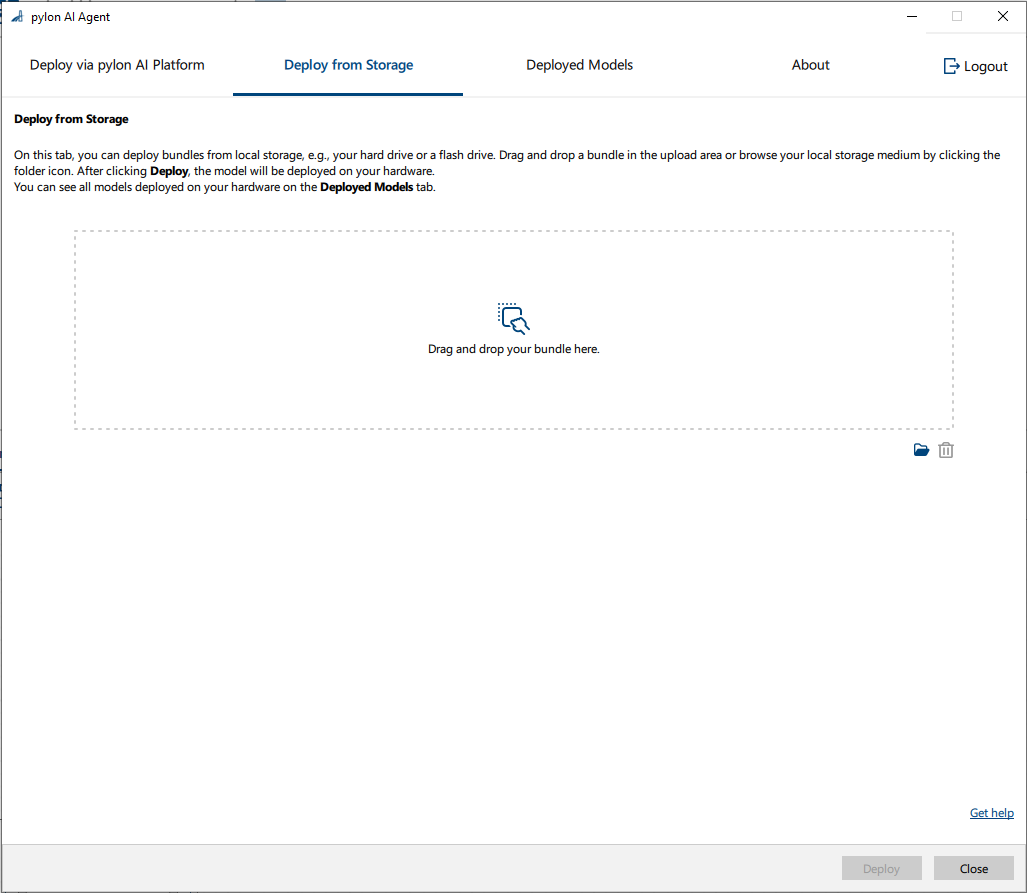
ストレージからモデルをデプロイするには、まず目的のモデルを含むバンドルをAI Platformから希望のストレージ媒体にダウンロードする必要があります。
モデルのデプロイ#
- Triton Inference Serverを起動します。
手順については、pylon AI用pylon Supplementary Packageに含まれているインストールマニュアルを参照してください。 - 次のいずれかの方法でpylon AI Agentを起動します。
- pylon ViewerのWorkbenchメニューから
- vToolの設定ダイアログから
pylon AI AgentがDeployed Modelsタブで開きます。ここでは、すでにデプロイされているモデルを確認できます。
-
ストレージから、または pylon AI Platform 経由で新しいモデルをデプロイするかどうかを決定します。
-
ストレージからのデプロイ
- まだダウンロードしていない場合は、pylon AI Platformから目的のバンドルをダウンロードします。
- ストレージからのデプロイタブに移動します。
- バンドルをドロップエリアにドラッグアンドドロップするか、フォルダアイコンをクリックして目的のバンドルファイルを参照します。
これは、ローカルまたはリモートのストレージロケーションのいずれでも可能です。 - デプロイをクリックします。
- ペインの サーバーの選択 ダイアログで、モデルをデプロイするTriton Inference Serverを選択します。
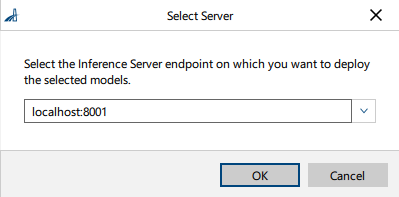
- OKをクリックします。
デプロイが直ちに開始されます。デプロイが完了すると、メッセージが表示されます。
-
pylon AI Platform経由でのデプロイ
- pylon AI Platform経由でデプロイタブに移動します。
- ログインボタンをクリックして、pylon AI Platformにログインします。
AI Platformに移動し、そこでサインインできます。その後、Webページが閉じ、AI Agentに自動的に戻るはずです。そうならない場合は、AI Agentに手動で戻って作業を続行してください。 - テーブルにリストされているバンドルから1つ以上を選択します。
- デプロイをクリックします。
- ペインの サーバーの選択 ダイアログで、モデルをデプロイするTriton Inference Serverを選択します。
- OKをクリックします。
デプロイが直ちに開始されます。デプロイが完了すると、メッセージが表示されます。
-
一般的な考慮事項#
- モデルの命名: Triton Inference Server上で同じ名前を持つ複数のモデルをデプロイすることはできません。各モデルは、Triton Inference Serverのモデルリポジトリ内で一意の名前を持つ必要があります。Triton Inference Serverはモデル名を識別子として使用し、推論リクエストを適切なモデルに管理およびルーティングするため、一意の名前が必要です。同じ名前のモデルが2つある場合、サーバーはそれらを区別できません。
- ネットワークの遅延と帯域幅: 十分な帯域幅が確保されていることを確認してください。特に帯域幅が制限されたネットワーク経由では、大規模なモデルのダウンロードに時間がかかることがあります。
- 十分なローカルストレージ: Triton Inference Serverでは、ダウンロードしたモデルをキャッシュまたは一時保存するために、十分なローカルストレージが必要です。ローカルストレージが限られている場合、大規模なモデルや複数のモデルを同時にデプロイする際に問題が発生する可能性があります。
- サーバーとvToolsをリモートで実行する場合: Triton Inference Serverをリモートコンピュータで実行しており、同時に別の場所からAI vToolsを実行している場合は、以下の重要な制限事項と考慮事項に注意してください:
- 推論リクエストを行うvToolとTriton Inference Serverの間でデータが転送されるのにかかる時間は、全体的な応答時間に影響を与える可能性があります。
- 高遅延は、特にリアルタイムアプリケーションにおいて、推論プロセスを遅くする原因となります。
- 限られたネットワーク帯域幅は、特に大量のデータを転送する際に、通信の遅延や不安定さを引き起こす可能性があります。