カーネルの操作#
このトピックを読むことで、カーネルの構築方法、フィルターオペレーターによる処理方法、および単一ピクセルに戻す方法を理解できます。 DmaToPC.
Kernel Structure#
カーネルとは、画像内の1つの位置の周囲にある、近傍のピクセル値の小さなウインドウです。Noise Reduction、ぼかし、エッジ検出などの多くのフィルターは、その近傍から新しい出力値を計算します。
3×3 kernelの場合、ウィンドウには9つの値が含まれます。つまり、その位置におけるcurrentピクセルと、8つの近傍ピクセルです。奇数のkernelサイズの場合、currentピクセルはウィンドウのcenterに位置します。
kernelは、画像上を左から右へ、行ごとに移動します。各位置で、フィルターはそのピクセルの周囲の近傍領域を使用します。
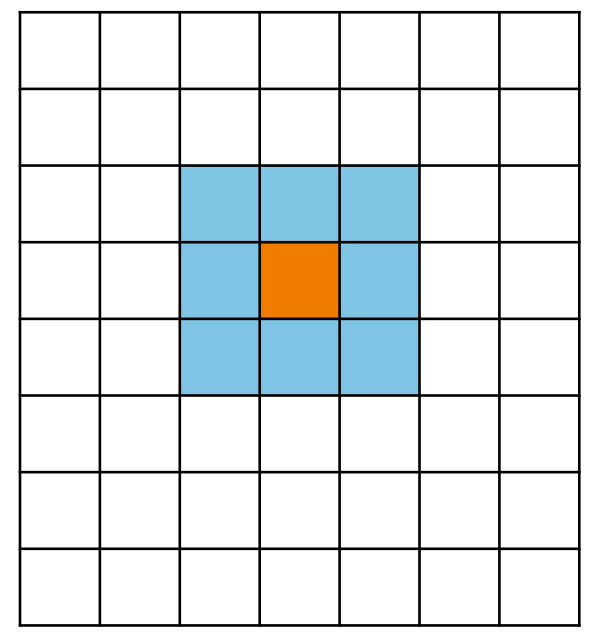
VisualAppletsでは、その近傍領域はlink propertiesによって定義されます。ウィンドウをどのように構築し、その中でcurrentピクセルがどこに位置するかは、オペレーターによって異なります。詳細については以下を参照してください。
Kernel Columns and Kernel Rows#
kernelサイズは次の要素の一部です: link properties. KernelColumns は近傍ウインドウの幅です。 KernelRows はその高さです。したがって、3×3カーネルでは以下を使用します KernelColumns = 3 と KernelRows = 3.
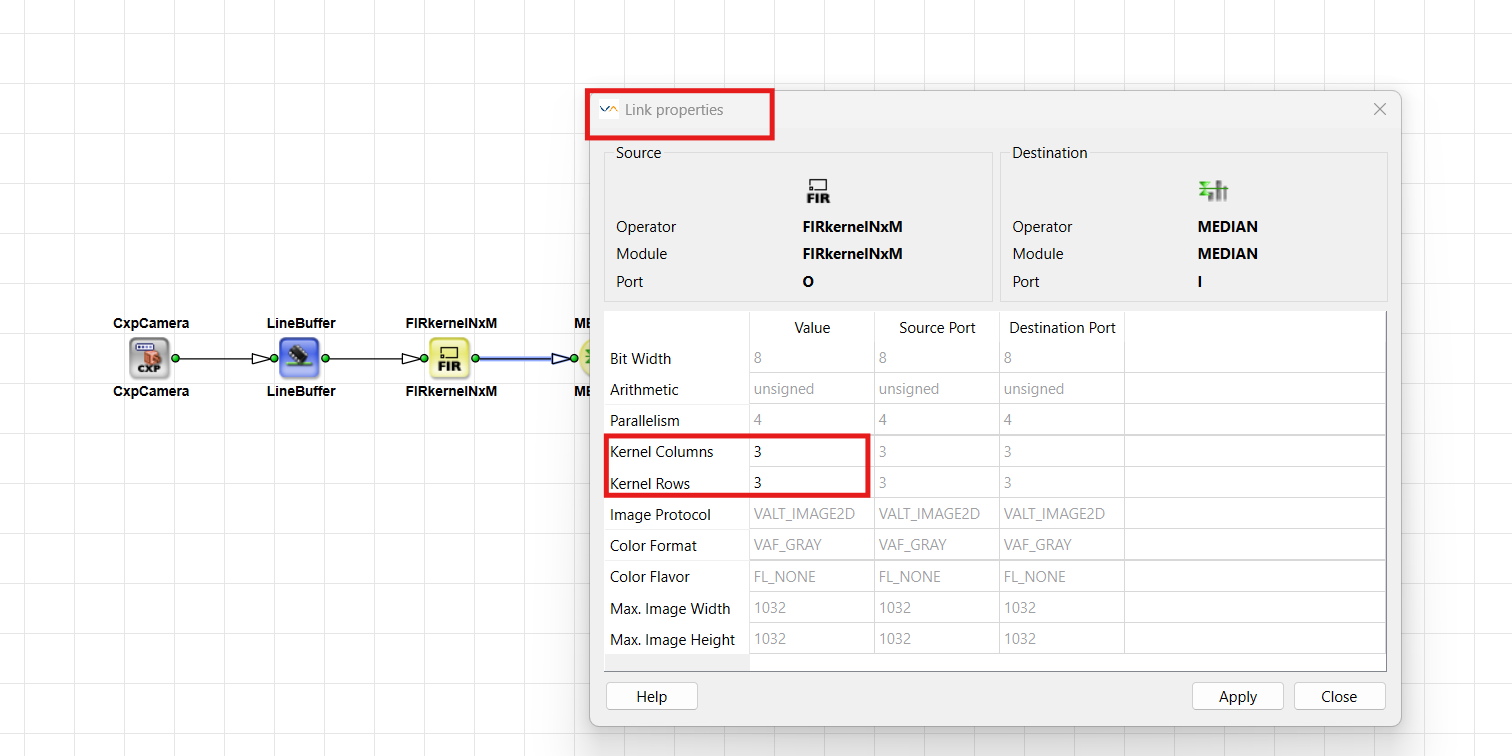
VisualAppletsにおいて、Nはkernel rowsの数であり、Mはkernel columnsの数です。kernel要素は座標ではなくインデックスによってアドレス指定されます。インデックスは左上から右下へ、行ごとに実行されます。
カーネルインデックスと画像位置の正確な対応関係については、常にオペレーターのドキュメントを確認してください。
すべてのオペレーターが1×1を超えるkernelを受け入れたり転送したりするわけではありません。各オペレーターは、許可されている値を次の場所で文書化しています: サポートされているリンクフォーマット の表( オペレーターリファレンス)。kernelリンクを許可されているオペレーターに接続する場合、 Kernel Columns = 1 および Kernel Rows = 1VisualApplets はリンクフォーマットの競合を報告します。
すべてのlink propertiesの概要については、Parameterizationのチュートリアルトピックを参照してください。
Kernels and Parallelism#
Parallelismとkernelsはどちらも、リンクが1クロックサイクルあたりに伝送するデータ量を増加させますが、これらは異なる概念を表しています:
| Parallelism | Kernel | |
|---|---|---|
| 質問 | 1クロックあたり何個のindependentピクセルが通過するか? | 1つの位置にいくつのneighbor valuesが属しているか? |
| 一般的な用途 | カメラとDMAの帯域幅を一致させる | 近傍領域を必要とするフィルターにデータを供給する |
| リンクプロパティ | Parallelism | KernelColumns, KernelRows |
カーネルを使用することで、Parallelism を 1 に維持したまま、1クロックあたりにより多くのデータを転送できます。リンクは1つの近傍領域(例: 3×3の値)を1つのデータワードとして搬送します。1クロックあたりのデータ量が増加するのは、1クロックあたりにより多くの新しい画像位置が処理されるからではなく、より多くの値が移動するためです。Parallelism チュートリアルのトピックにあるピクセルレート帯域幅の計算式には、カーネルサイズは乗算されません。
両者を組み合わせることも可能です。オペレーター CastKernel は、その積が変わらない限り、入力と出力の間で Parallelism とカーネルサイズの積を再解釈できます。たとえば、Parallelism が 1 でカーネルが 3×2 の場合、Parallelism が 6 でカーネルが 1×1 になることがあります。
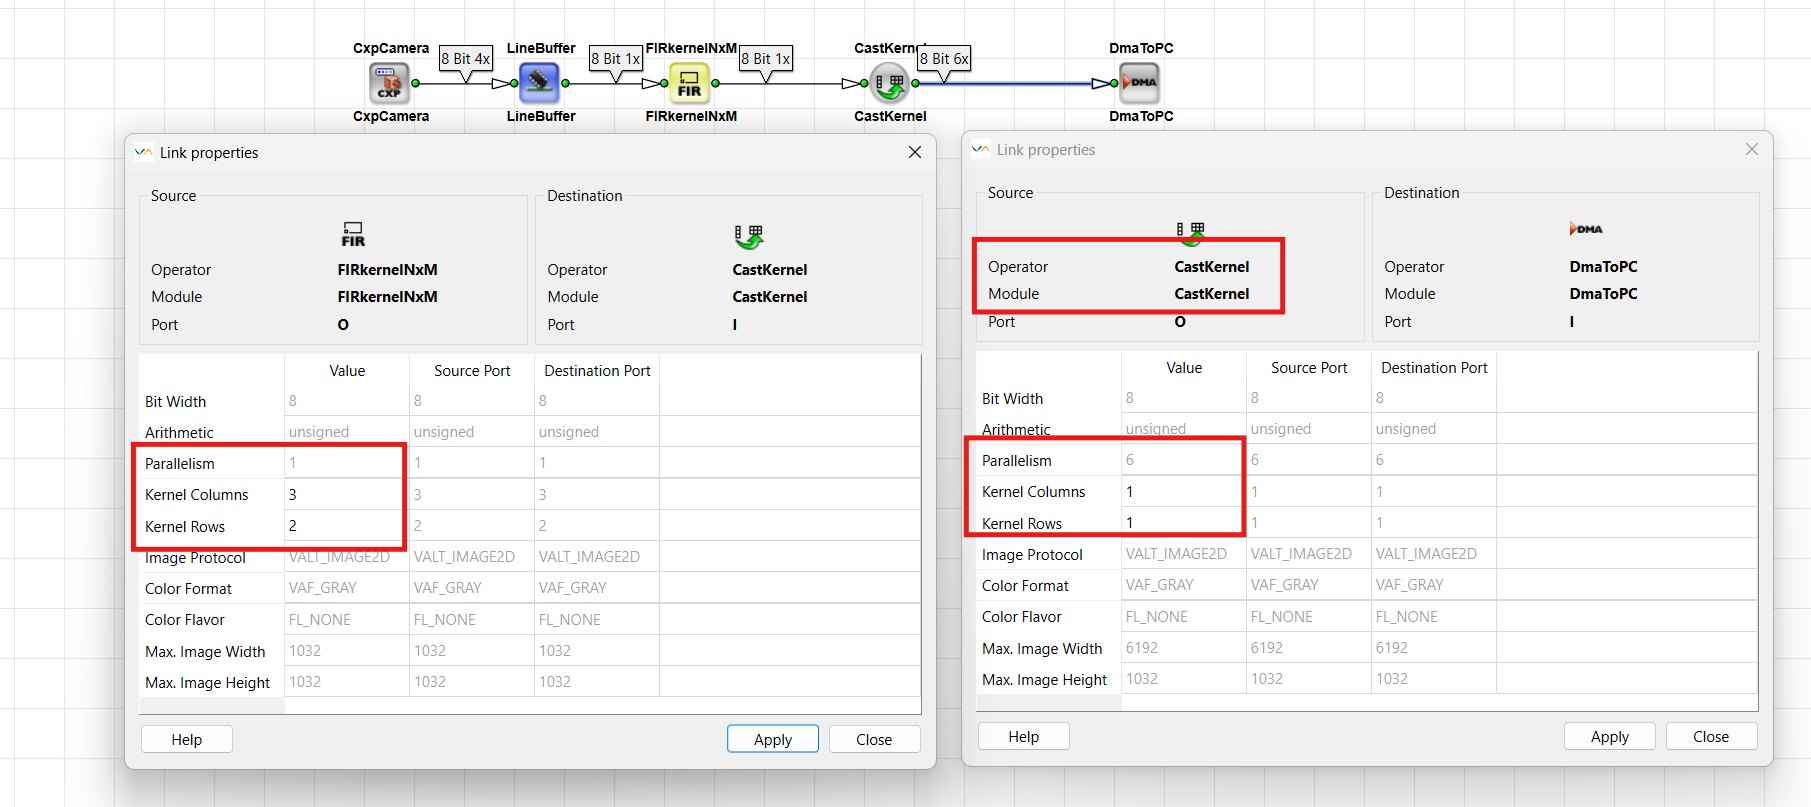
詳細については、オペレーターリファレンスの CastKernel と Parallelism のチュートリアルを参照してください。
Building Kernels#
通常のピクセルストリームから近傍データを生成するには、リンク上でカーネルサイズを設定する 出力 オペレーターを使用します。 FIRkernelNxM は中央揃えの 2D カーネルウインドウを構築します。 LineNeighboursNx1 および PixelNeighbours1xM は特殊なケースであり、中央揃えのウインドウではなく、以前のラインや以前のピクセルを収集します。これらのオペレーターは、現在のピクセルの位置、オペレーターの種類、FPGA のコストとレイテンシー、およびエッジ処理(下記参照)において異なります。ユースケースに一致するオペレーターを選択してください。中央揃えの 2D フィルター近傍、以前のラインまたはピクセルにわたる比較、あるいは完全な FIR スタイルウインドウのリソース効率の高い代替手段のいずれかを選択します。
FIRkernelNxM#
オペレータ FIRkernelNxM (ライブラリ フィルター)は、隣接ピクセルを含め、各ピクセルの周囲に長方形のカーネルウインドウを作成します。その名称とは異なり、FIRフィルターを 行いません 実装している わけではありません 。フィルターオペレーターに必要なカーネルデータを準備します。奇数のカーネルサイズの場合、現在のピクセルはカーネルの中心に位置します。偶数のカーネルサイズの場合、正確な中心は存在せず、中央の位置は左上にオフセットされます。
3×3 アベレージフィルターによる平滑化:
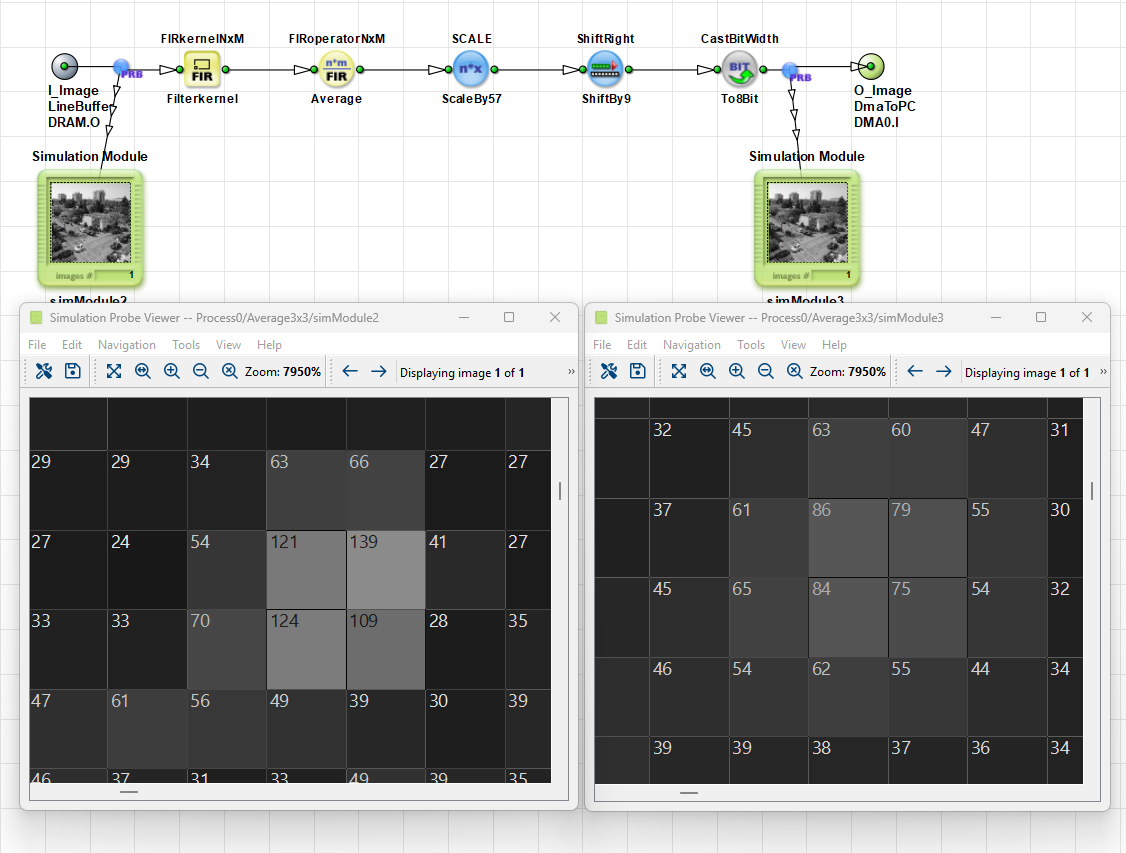
このデザインは、中央揃えの 3×3 近傍を FIRkernelNxM (Filterkernelで構築し、 FIRoperatorNxM (Averageで平均化してから、結果をスケーリングして 8 ビットにキャストします。シミュレーションプローブは、平均化前後のピクセル値を比較します。鋭い局所的なピークが、より滑らかで均一な値になります。
出力リンク(Kernel Columns および Kernel Rows)を編集してカーネルサイズを定義します。オペレーターは、完全な近傍が利用可能になるまで必要なピクセルをバッファリングします。画像の外縁部では、近傍が不足する場合があります。パラメーター EdgeHandling は、不足している値がどのように埋められるかを選択します(EdgeMirrored または EdgeConstantを使用します。
FIRkernelNxM は Mタイプ オペレーターです。3×3 のような中心が揃った近傍領域の構築にはバッファリングが必要となるため、以下のラインまたはピクセル近傍オペレーターと比較してより多くの FPGA リソースを使用し、遅延が増加します。フィルターで真に中心が揃った 2D 近傍領域が必要な場合(例えば、 FIRkernelNxM を使用します の前など ) FIRoperatorNxM ぼかし、平均化、エッジ検出に使用します。
オペレーターの詳細については、オペレーターリファレンスの FIRkernelNxM を参照してください。
LineNeighboursNx1 および PixelNeighbours1xM#
LineNeighboursNx1 および PixelNeighbours1xM は特殊なケースです。通常の意味での中心付きカーネルを構築しません。
LineNeighboursNx1 N 行 1 列のカーネルを作成します。現在のピクセルは カーネルインデックス 0にあり、他の要素は前のライン(上側)のピクセルです。 PixelNeighbours1xM 1 行 M 列のカーネルを作成します。現在のピクセルは再び次の場所にあります カーネルインデックス 0;その他の要素は、同じ行の以前のピクセル(左側)です。
とは異なり、 FIRkernelNxMこれらのオペレーターは、 行いません 現在のピクセルを中心とし、まだ処理されていない「未来の」近傍を提供しません。これらは 過去 (以前の行または以前のピクセル)のみを参照します。これらは Oタイプ オペレーターであり、中央に配置された近傍のバッファリングに起因する行またはピクセルの遅延を追加しません。そのため、これらはよりシンプルであり、FPGAリソースの消費量も通常、 FIRkernelNxMよりも少なくなります。引き続きより大きな近傍を形成することは可能です(たとえば、両方のオペレータを3×3のウィンドウに結合するなど)。ただし、行または画像の開始時には過去の近傍がまだ利用できないため、十分な履歴が収集されるまでそれらのカーネル要素は空のままになります。画像境界の外側にある欠損ピクセルは、パラメータ Constantに設定され、ミラーリングされたエッジ処理はありません。
一般的なユースケース:
-
複数行にわたる値の比較または削減 以前の行 を
LineNeighboursNx1(例:現在のピクセルとその上方の行の最小ピクセル値を検出する):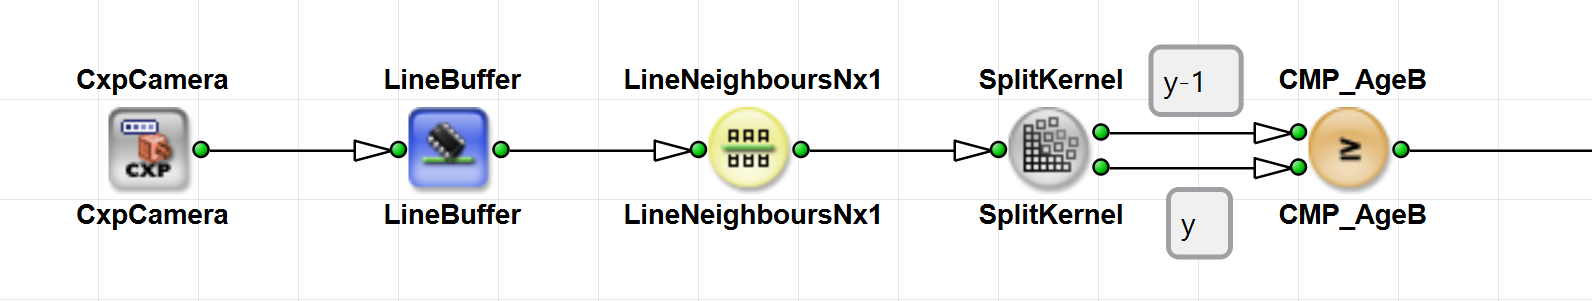
-
複数行にわたる値の比較または削減 同じ行上の以前のピクセル を
PixelNeighbours1xM.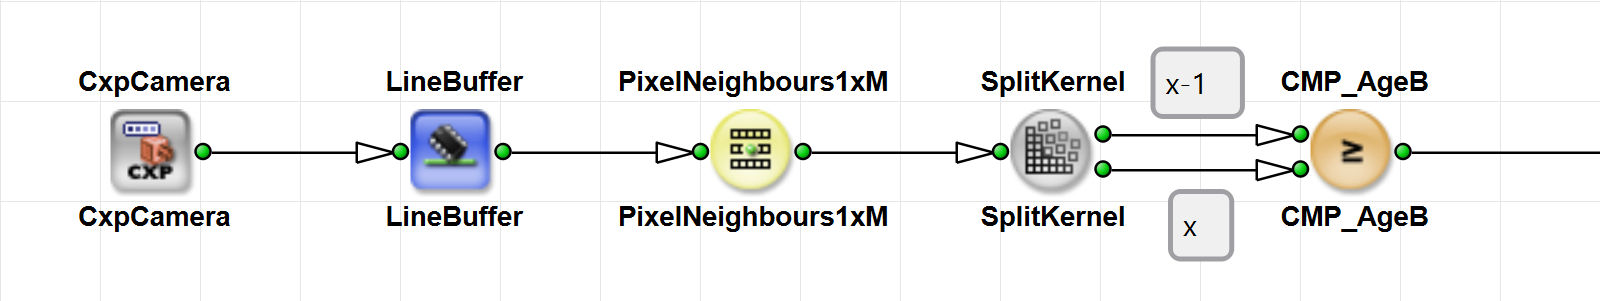
-
次のような削減オペレータにフィードします。
MINまたはMAX:これらのオペレーターは入力上でカーネルを予期し、近傍から1つの値(例えば最小ピクセル)を選択し、 1×1 の結果を出力します。そのステップの後、カーネルは再び解決されます。隣接行間の最小ピクセル値:
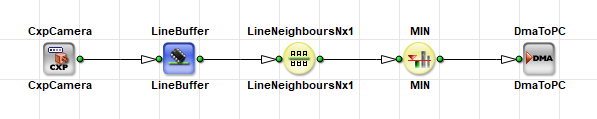
隣接ピクセル間の最大ピクセル値:
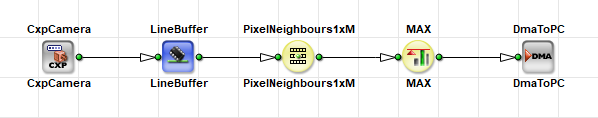
二次元カーネルを構築するには、次を組み合わせることができます。 LineNeighboursNx1 その後に以下が続きます。 PixelNeighbours1xM.
オペレーターの詳細については、オペレーターリファレンスのLineNeighboursNx1およびオペレーターリファレンスのPixelNeighbours1xMを参照してください。
ExpandToKernel#
オペレータ ExpandToKernel 単一のピクセル入力を任意のカーネルサイズに拡張します。これは、 複製します 入力値をすべてのカーネルコンポーネントに反映させます。出力リンクで新しいカーネルサイズを定義します。
使用 ExpandToKernel ダウンストリームのオペレーターが入力でカーネルを予期しているにもかかわらず、 単一の ピクセル値(しきい値、平均、参照ピクセルなど)しかない場合。一般的なパターンは、その定数または参照を拡張して、 FIRkernelNxM, LineNeighboursNx1、または PixelNeighbours1xMからの既存の近傍と一致させることです。その後、次のようなオペレータを適用できます。 CMP, SUB、または ADD フルカーネル全体で要素ごとに(たとえば、すべての近傍を同じしきい値と比較するなど)。
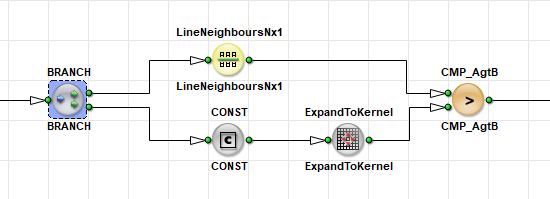
オペレーターの詳細については、オペレーターリファレンスのExpandToKernelを参照してください。
Processing Kernels#
カーネルを構築したあとは、そのフィルタリング、サブセットの抽出、カーネルストリームの結合または分割、あるいはカーネルコンポーネントの並べ替えを行うことができます。このセクションのオペレータは、既存のカーネルを処理します。 DmaToPC、カーネルを1×1に縮小する必要があります。以下を参照してください: Connecting to DMA.
FIRoperatorNxM#
オペレータ FIRoperatorNxM は、各カーネル要素に係数を乗算し、その積の総和を求めます。これらの係数は、 Coefficients パラメータ。
の出力は FIRoperatorNxM 演算子のカーネルサイズは1×1であり、これは1位置あたり1つのフィルタ処理済みピクセル値が得られることを意味します。 FIRkernelNxM, LineNeighboursNx1、または PixelNeighbours1xM を使用して、必要な入力カーネルを生成します。
リンク上にすでに近傍が存在し、1位置あたり1つのフィルタ処理済み出力ピクセルが必要な場合、古典的なFIRスタイルのフィルタ(平均化、ガウス、Sobel、および類似のフィルタ)にはこの演算子を使用します。
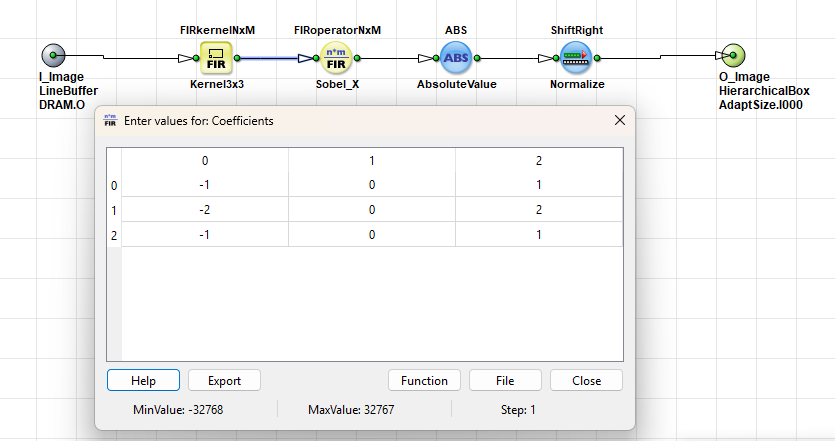
スクリーンショットは、VisualAppletsに付属しているデザイン例 Examples\Processing\Filter\EdgeDetection\SobelGradientXを示しています。
オペレータの詳細については、オペレータリファレンスのFIRoperatorNxMを参照してください。
SelectSubKernel#
イメージ SelectSubKernel 演算子は、入力カーネルの長方形のサブセットを抽出します。そのパラメータ FirstROW および FirstCOL はサブセットのオフセットを定義します。新しいカーネルサイズは出力リンクで設定されます。
Using SelectSubKernel 次の要素を抽出します 中央の カーネルの要素(通常はその画像位置の元のピクセル) — 完全な近傍領域が不要になった場合。
典型的なユースケースは、フィルターを適用しながらも、次の要素を維持することです。 元画像 画像。以下を実行した後: FIRkernelNxM が近傍を構築した後、カーネルリンクを分岐させます。1つのパスでフィルタ処理された結果を計算します。もう1つのパスでは、 SelectSubKernel を使用して1×1のサブカーネル(その画像位置の元のピクセル)を抽出します。これにより、フィルタ処理済みデータとフィルタ処理されていない画像の両方を得ることができます。
フィルタの隣に元の画像データを保持する:
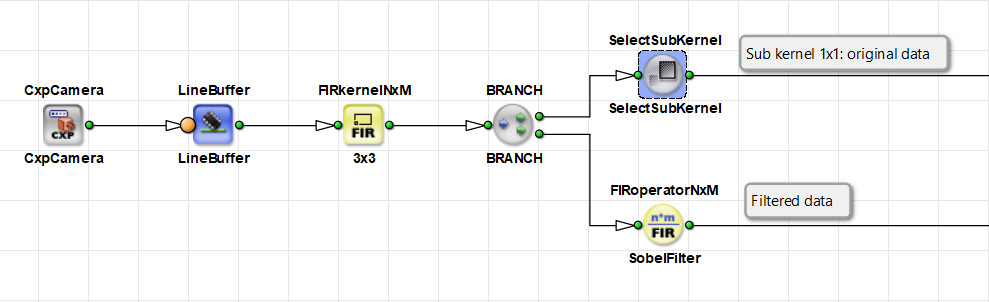
デザインは、 FIRkernelNxMを使用して3×3の近傍を構築し、その後分岐します。上側のパスは、 SelectSubKernel を使用して元のピクセル(1×1サブカーネル)を抽出します。下側のパスは、 FIRoperatorNxM をSobelフィルタとして適用します。
オペレータの詳細については、オペレータリファレンスのSelectSubKernelを参照してください。
MergeKernel および SplitKernel#
オペレータ MergeKernel は、複数の入力リンクを1つの出力カーネルにマージします。このため、いずれか1つのカーネル次元(行または列のいずれか)がすべての入力で一致している必要があり、入力側のもう一方の次元は異なっていてもかまいません。 Alignment パラメータ(値は horizontal または vertical )は、入力を結合する方法を定義します。
対となる演算子は SplitKernel. SplitKernel であり、N×MカーネルをN×M個の別々の出力リンクに分割し、それぞれカーネルサイズを1×1にします。出力数はカーネルコンポーネントの数と一致している必要があり、演算子のインスタンス化時に固定されます。
典型的なユースケースは、次の要素を組み合わせることです。 同じ画像の複数のバリアント — 例えば、異なるグレースケールや処理済みバージョン — を1つのカーネルにまとめて、比較や一括処理を行うことができます。以下を使用します: SplitKernel 個別のカーネルコンポーネントを再び個別のパスで処理する必要がある場合。
組み合わせて使用することで、 MergeKernel および SplitKernel 本来なら以下が必要となる設計の代替としても機能します。 SYNC オペレーター: SYNC 通常、入力側にバッファが必要となるため、FPGAリソースが消費されます。代わりにストリームをカーネルコンポーネントとして伝送できる場合、カーネルの統合と分割のほうが、よりリソース効率の高いアプローチとなることがよくあります。
このパターンを使用するのは、次の対象に対してのみにしてください: 同じ画像の複数のバリアント 共通のソースを共有し続けるもの(例えば、1つのカメラストリームにおける2つの異なる処理パスなど)です。 行いません use MergeKernel 2台の独立したカメラを統合するため。独立したカメラは非同期ソースのままであり、依然として以下が必要です SYNC (または非同期入力を持つ別のオペレータ)とバッファ。以下を参照してください: オペレータータイプと同期 チュートトリアルのトピック。
非同期パスを統合する際の同期エラー:
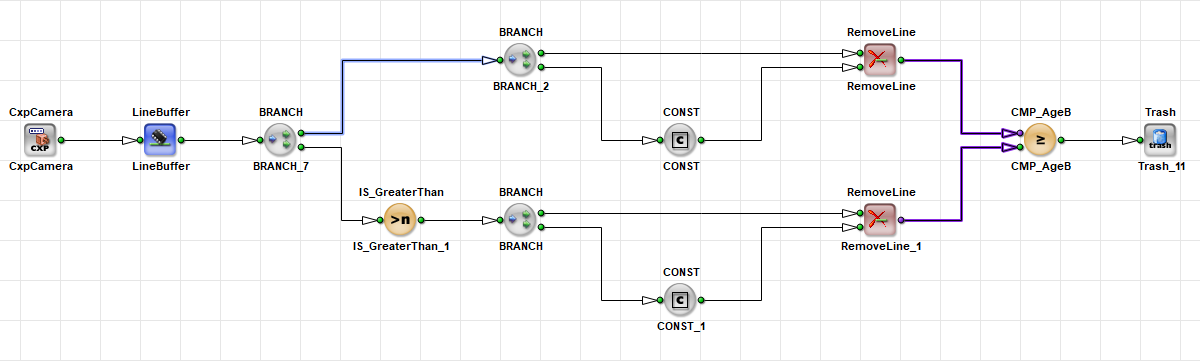
ここでは2つのブランチで同じ画像を異なる方法で処理し、共通の CMP オペレーターにデータを送ります。一方のパスのM型オペレーターによってブランチが非同期化されているため、VisualAppletsは同期エラー(紫色のリンク)を報告し、直接接続することはできません。この例は2台の独立したカメラではなく、依然として1台のカメラです。
バッファと SYNC で解決された同期エラー:
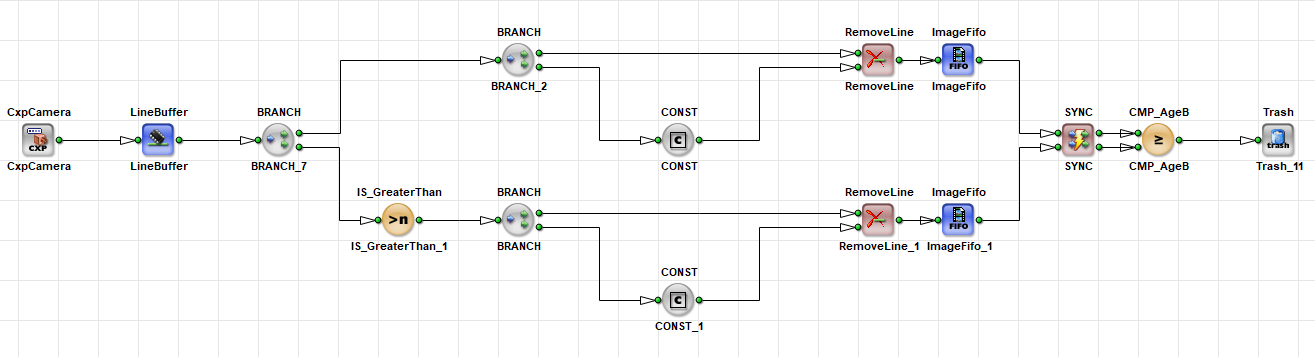
有効な修正方法の1つは、各パスに ImageFifo (または別のバッファ)を配置し、次を使用して再同期することです SYNC 以下の前で CMP。これは機能しますが、追加のバッファによってFPGAリソースが消費されます。
MergeKernel と SplitKernel で解決された同期エラー:
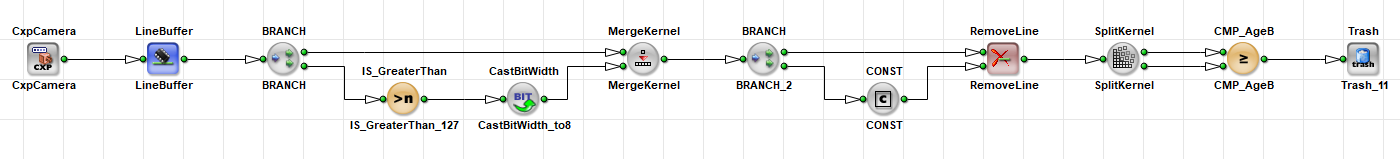
リソース効率の高い代替方法では、両方のバリエーションをカーネルコンポーネントとして伝送します: MergeKernel は2つのパスを1つのカーネルリンクに結合し、そのリンク上で処理が継続され、 SplitKernel は次の処理の前にコンポーネントを再度分離します CMP。以下は不要です SYNC また、追加の同期バッファも必要ありません。
同期および同期エラーの詳細については、Operator Types and Synchronizationチュートリアルのトピックを参照してください。
オペレータの詳細については、オペレータリファレンスのMergeKernelおよびオペレータリファレンスのSplitKernelを参照してください。
CastKernel#
CastKernel は、受信データの Parallelism とカーネルサイズを再編成します。出力リンクでカーネルサイズを変更できます。カーネルの行数、列数、および Parallelism の積は、入力と出力で同一である必要があります。
Using CastKernel 変換できます カーネルへの Parallelism。たとえば、1×1のカーネルを持つ Parallelism 48 は、48のカーネル列を持つ Parallelism 1 に変換されます。同じ48ピクセル値が1クロックサイクルで移動しますが、並列ピクセルではなくカーネルコンポーネントになります。これは、特定の Parallelism のみを許可する Memory オペレーターの前に使用する場合に便利です。
Memoryオペレーターの前でのParallelismのカーネルへの変換:
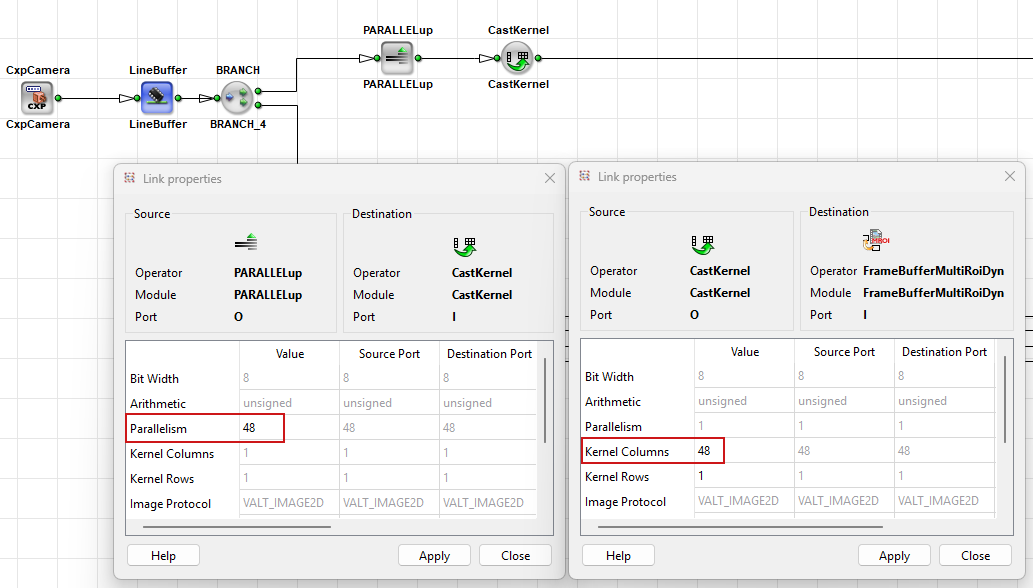
スクリーンショットでは、 PARALLELup はParallelismを48に引き上げます(1×1カーネル)。 CastKernel はそれを48カーネルカラムを持つParallelism 1として再解釈するため、後続のMemoryオペレーターがデータを受け入れることができるようになります。
オペレーターの詳細については、オペレーターリファレンスの CastKernel を参照してください。
KernelRemap#
KernelRemap は、入力と出力の間でカーネルコンポーネントを再マップします。カーネルの寸法は変わりません。 SourceSelect パラメータを使用すると、各出力カーネルコンポーネントに入力カーネルインデックスを割り当てることができます。
このオペレーターを使用すると、カーネルコンテンツの反転や回転、1つの入力要素の複数の出力へのマッピング、または未使用の入力要素の破棄を行うことができます。
KernelRemapを使用したカーネルカラムのスワップ:
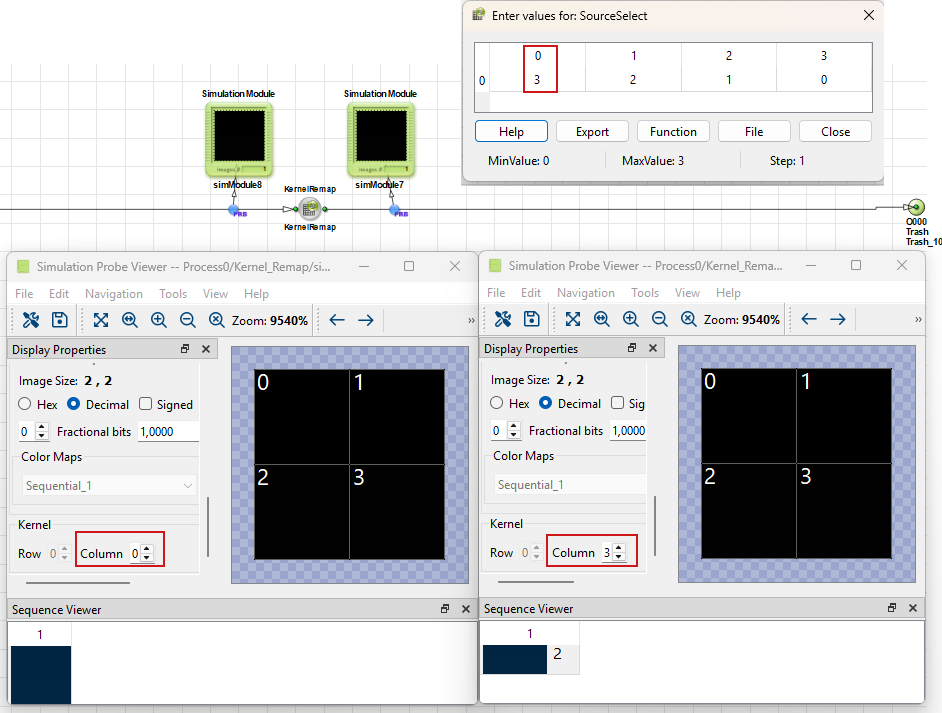
スクリーンショットのデザインは、 KernelRemap がどのようにカーネルカラムをスワップするかを示しています:カラム0とカラム3が場所を交換します(内側のカラムもそれに続きます)。マッピングの由来は、 SourceSelect パラメータであり、ここでは 0, 1, 2, 3 → 3, 2, 1, 0です。シミュレーションプローブは、リマップ前後のカーネルコンポーネントを示しています。
オペレーターの詳細については、オペレーターリファレンスの KernelRemap を参照してください。
Connecting to DMA#
生カーネルリンクは次の場所に配置する必要があります 行いません 直接 DmaToPC. DmaToPC は受け入れないため、 Kernel Columns = 1 および Kernel Rows = 1.
を受け入れません。 DmaToPC。そのため、カーネル出力と
FIRoperatorNxMSelectSubKernelSplitKernelMINまたはMAXMedian
設計例#
の間に必ず次のいずれかのオペレーターを配置してください。これらのオペレーターは、カーネルをシングルピクセルまたはさらに縮小できる小さめのカーネルに変換します:
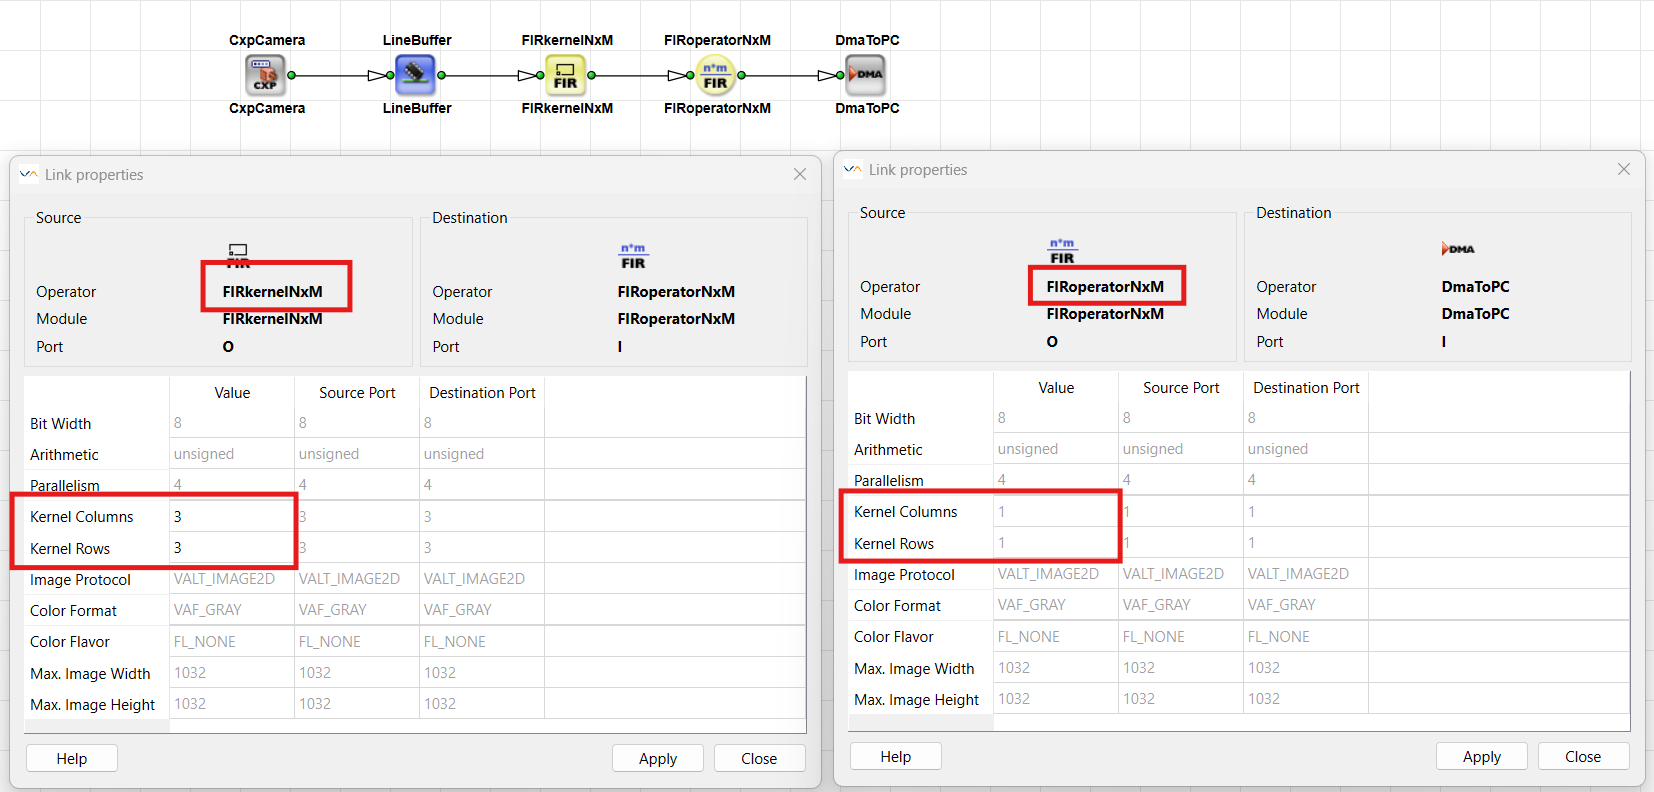
- 典型的なフィルターパスは次のようになります:
- カメラはシングルピクセル(1×1カーネル)を出力します。
LineBufferまたはImageBufferなどのバッファが、カメラを処理から切り離し、近傍オペレーターが必要とするラインデータを提供します。 FIRkernelNxMは、出力リンク上で、例えば3×3や5×5などの近傍ピクセルからカーネルを構築します。FIRoperatorNxMはフィルター係数を適用し、位置ごとに1つのピクセルを出力します。DmaToPCシングルピクセルストリームをホストに転送します。
詳細なフィルターの例(平均化、ガウス、Sobel、適応的しきい値など)は、オペレーターリファレンスの FIRkernelNxM および FIRoperatorNxM の Examples of Use セクションに記載されています。
設計ガイドライン
常に確認してください サポートされているリンクフォーマット リンク上で 1×1 より大きいカーネルを作成する前の、後続のオペレーターの。特に前 DmaToPC、カーネルを1×1に縮小します。
関連トピック#
- パラメータ設定 チュートリアルトピック —
KernelColumnsおよびKernelRowslink properties - Parallelism チュートリアルのトピック — Parallelism とカーネルデータレート
- Latency チュートリアルのトピック — バッファおよびフィルターオペレーターのレイテンシ
- オペレーターリファレンスの FIRkernelNxM
- オペレーターリファレンスの FIRoperatorNxM
- オペレーターリファレンス
- ユーザーマニュアルの Parameterization — GUI でのリンクおよびモジュールパラメータの編集