Parallelism#
主要用語
Base Design Clock は、フレームグラバー上の生成された FPGA パイプラインのクロックです(例: 312.5 MHz)。これはカメラのピクセルクロックとは異なり、VisualApplets エディター内のクロックでもありません。クロックサイクルとは、Base Design Clock の 1 つのティックのことです。1 クロックサイクルあたりにリンクを通過できるピクセル数は一定で、その数を Parallelism と呼びます。Parallelism が 4 の場合、1 クロックサイクルあたり 4 ピクセルとなります。Base Design Clock の周波数が高いか、または Parallelism が高いほど ピクセルレート(このトピックでは 帯域幅 と呼びます)が増加します。
平行度と帯域幅#
Parallelism は、生成された FPGA パイプラインのリンクを 1 クロックサイクルあたりに流れるピクセル数です。
Parallelismは、モジュール内の処理の粒度に影響を与えます。たとえば、 LineBuffer パラメータ XLength はParallelismに依存します。
次のルールが適用されます。
- Parallelismが高いほど、ピクセルレートの帯域幅が広くなります。
- Parallelismが高いほど、FPGAリソースの使用量が増加します。
ビット幅とカーネルサイズはこのピクセルレートの数値には含まれません。これらはクロックあたりのデータ量を増加させ、DRAMやリソースにとって重要になります。Working with Kernels のチュートリアルトピックおよび Memory Elements のチュートリアルトピックを参照してください。
設計ガイドライン
FPGAリソースを節約するため、Parallelismは必要以上に高くしないようにしてください。
ピクセルレートとしてのリンクの帯域幅は、次の式に従って計算されます。
帯域幅 = Parallelism × Base Design Clock
Base Design Clock は使用するフレームグラバーによって異なります。Basler フレームグラバーの場合は、Device Resources で値を確認してください。
主要用語
Link Info および Throughput フラグを使用すると、デザイン内の平行度とデータスループットを表示させることができます。ツールバーから次のボタンを使用してこれらのフラグを有効にします。
その結果、デザインに Link Info および Throughput フラグが表示されます。
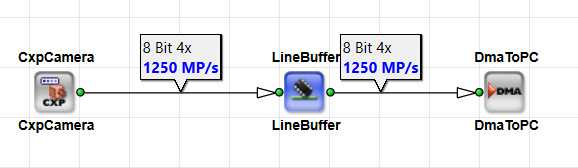
このトピックでは、Link InfoおよびThroughputフラグを有効にしたデザインのすべてのスクリーンショットを示します。
必要な平行度の計算#
デザインの寸法を見積もるには、まず必要なピクセルレートを計算し、次にBase Design Clockから必要なParallelismを導き出します。
エリアスキャンデザインの平行度の計算#
エリアセンサカメラを使用するデザインの場合は、まず秒間ピクセル数で帯域幅を計算します。
帯域幅 = (1ラインあたりのピクセル数)×(1フレームあたりのライン数)×フレームレート
次に、帯域幅を使用して必要なParallelismを計算します。
必要なParallelism = 帯域幅 / Base Design Clock
計算された要件以上である、サポートされている最小のParallelismを選択します。切り捨てを行うと、デザインの帯域幅が要件を下回ってしまいます。たとえば、Base Design Clockが312.5 MHzで6000 MP/sの場合、Parallelismは19.2必要になります。Parallelism 19では5937.5 MP/sしか得られず、不足します。20を使用するか、お使いのプラットフォームで許可されている次の高い値を使用してください。
エリアスキャンの計算例#
解像度2064 × 2064ピクセル、フレームレート30フレーム/秒のカメラの場合、次の帯域幅計算が適用されます。
帯域幅 ≈ 2064 × 2064 × 30 ≈ 127.9 MP/s
Base Design Clockが312.5 MHzの場合、計算されるParallelismは次のようになります。
必要な Parallelism ≈ 127.9 / 312.5 ≈ 0.41 → 切り上げて1
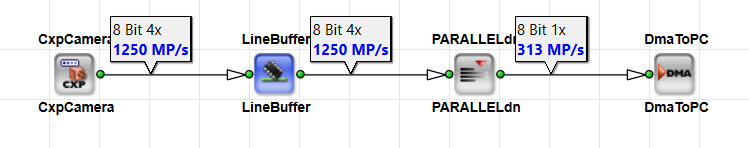
上のスクリーンショットは、対応するVisualAppletsデザインの実装を示しています。次の箇所のParallelism: カメラインターフェイス が次のように設定されている場合、自動的に無効になります: 4。この値は、帯域幅の計算から得られる処理側の Parallelism ではありません。 CxpCamera オペレーターは、次の項目で定義されたCXP接続の数からインターフェイスのParallelismを自動的に設定します。 ConnectionCount モジュールパラメータ(この場合、 x1)。インターフェースの Parallelism と必要な処理の Parallelism は異なります。必要な処理の Parallelism は 1であるため、リンクの Parallelism は次のように削減されます。 1 の出力リンクで LineBuffer オペレータ。
低いフレームレートでは、Parallelism の値として 1 で十分です。より高いフレームレートや解像度では、必要な Parallelism が増加します。値を計算し、サポートされている次のレベルに切り上げます(例: 2, 4、または 8)。プラットフォームで 偶数 のParallelismが必要な場合は、最初に切り上げてから、次に高い有効な偶数値を選択します。たとえば、計算結果が 6.3の場合は、 8を使用し、 7.
ラインスキャンデザインの平行度の計算#
ラインスキャンカメラを使用するデザインでは、まずピクセル/秒単位で帯域幅を計算します。
Bandwidth = (1ラインあたりのピクセル数) × ラインレート
次に、帯域幅を使用して必要なParallelismを計算します。
必要なParallelism = 帯域幅 / Base Design Clock
プラットフォームのルールと許可されている Parallelism の値に従って、結果を切り上げます。
ラインスキャンの計算例#
解像度16384ピクセル、ラインレート120 kHzのカメラの場合、次の帯域幅計算が適用されます。
Bandwidth ≈ 16384 × 120 kHz ≈ 1966.08 MP/s
Base Design Clockが312.5 MHzの場合、計算されるParallelismは次のようになります。
必要な Parallelism ≈ 1966.08 / 312.5 ≈ 6.3 → 切り上げて7
計算結果は 6.3となるため、次の整数は 7)。プラットフォームで 偶数 のParallelismになる場合は、次に高い有効な偶数値を選択します(8であり、 7ではありません)。下のスクリーンショットでは Parallelism として 7を使用しており、偶数の Parallelism が不要な場合に有効です。
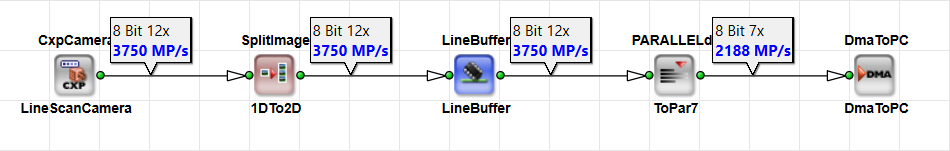
上のスクリーンショットは、対応するVisualAppletsのデザイン実装を示しています。カメラインターフェースでの Parallelism は次のように設定されています。 12この値は、CXP接続の数から CxpCamera CXP接続の数からのオペレーター(ConnectionCount パラメータが次のように設定されています x2に設定されています)。インターフェイスのParallelismは、必要な処理のParallelismとは再び異なります。 SplitImage operatorは1Dから2Dへの変換を実行します。 LineBuffer その後、 7 operatorがリンクのParallelismを削減し、計算された処理要件に一致させます。
デザインにおける平行度の変更#
以下のオペレーターは、デザインのParallelismをbandwidth requirementsに適合させます。
平行度の増加または減少#
PARALLELdn— Parallelismを削減します。次を参照してください: PARALLELdn オペレーターリファレンス。PARALLELup— Parallelismを増加します。次を参照してください: PARALLELup オペレーターリファレンス。- LineBuffer(imaFlexのみ): イメージ
ParallelismConverterのLineBuffer追加のParallelismオペレーターを使用せずに、入力と出力の間のParallelismを調整するオペレーター。次を参照してください: LineBuffer (imaFlex) オペレーターリファレンス。
ストリームの分割、選択、マージ#
SplitParallel— 高いParallelismを持つ1つのデータストリームを、より低いParallelismを持つ複数のストリームに分割します。例:Parallelism8が、それぞれParallelism4それぞれ。次も参照してください: SplitParallel オペレーターリファレンス。SelectFromParallel— 並列ストリームから個々のコンポーネント(クロックサイクルあたりに転送される複数のデータワードのうちの1つなど)を選択します。次も参照してください: SelectFromParallel オペレーターリファレンス。MergeParallel— 個別の処理後に並列ストリームを再びマージします。次も参照してください: MergeParallel オペレーターリファレンス。
その他のオペレータ#
CastParallel— リンク上のビットを再解釈します。ParallelismとBit Widthは、次が維持される限り変更される可能性があります: Bit Width × Parallelism 入力と出力で等しく保たれます。例:16 bit × PAR 2 は 8 bit × PAR 4 になります。画像幅もそれに応じて変化します。以下も参照してください CastParallel オペレーターリファレンス。ExpandToParallel— Parallelism 1 の入力を受け取り、目的の出力 Parallelism を生成します。入力値はすべての並列チャネルに複製されます。以下も参照してください ExpandToParallel オペレーターリファレンス。
使用事例#
次のようなユースケースが頻繁に発生します。
-
使用
PARALLELupParallelismを増加させ、並列ブランチでデータを処理し、MergeParallel.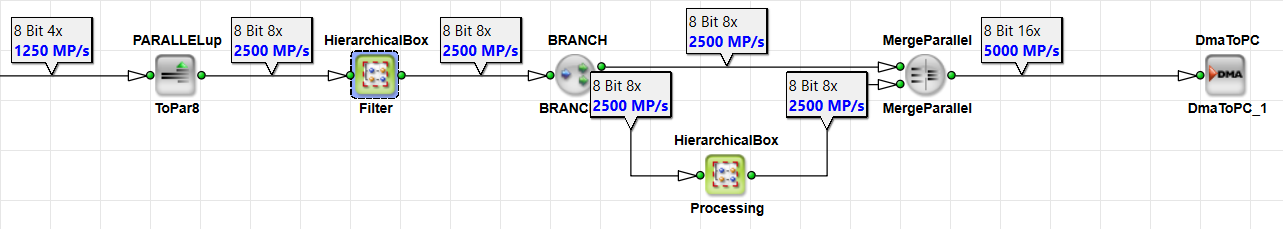
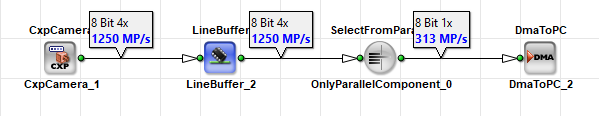
-
でブランチを再びマージします。
SelectFromParallelParallelism4ストリームから1つのチャネルのみを転送するには、
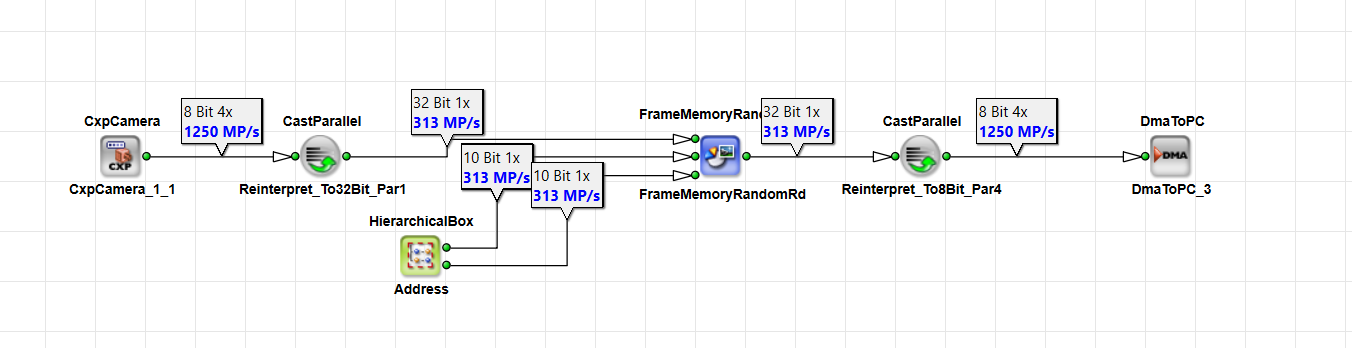
-
FrameBufferRandomReadの後、ストリームはParallelism1例えば、1ピクセルあたり64ビットの場合です。後段の処理をより高い Parallelism で実行するには、データストリームを 8 ビット × Parallelism として再解釈します。8。これを行うには、次を使用します:CastParallelオペレータ。
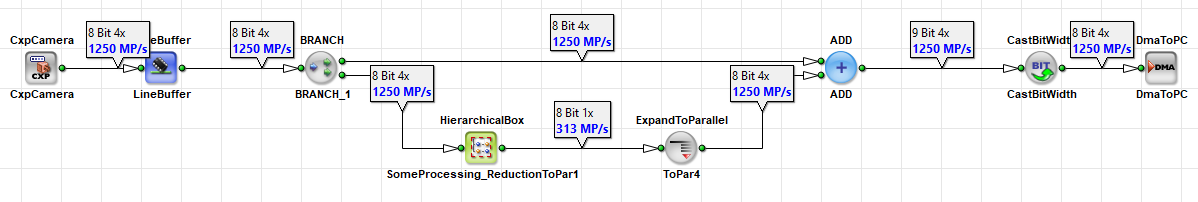
- 使用
ExpandToParallel制御値またはピクセルストリームを Parallelism で拡張するには、1Parallelism へ4平行分岐内の係数やマスクなど、同じ値が4つのすべての並列チャネルで利用可能でなければならない場合。
平行度の制限#
最大画像幅(ピクセル単位)は、Parallelism で割り切れる必要があります。
例:
- Parallelism が
4の場合、許可される画像幅には 1024 や 2048 が含まれます。 - Parallelism が
12、画像幅 16384 は 行いません 16384 / 12 は整数ではないため許可されません。
回避策:
- ダミーピクセル — 画像幅が Parallelism の値で均等に割り切れるようになるまで、たとえばシミュレーションリンクプロパティやオペレーターを使用して画像を広げます。
- Crop — 有効な画像幅になるように画像をトリミングします。
主要用語
生成された FPGA ハードウェアは、クロックあたりのパケット単位でピクセルを処理します。16384 / 12 は整数ではないため、16384 ピクセルのラインは Parallelism 12 に綺麗にパッキングされません。そのため VisualApplets では、デザイン内の画像幅が Parallelism で割り切れることを要求します。
メモリオペレータを使用した平行度#
FrameBufferRandomRead 許可されるのは Parallelism 1のみです。これは、メモリがシーケンシャルにアクセスされるためです。デザイン内でより高い Parallelism を使用し、全体的な帯域幅に影響を与えないようにするには、次の方法を使用して並列コンポーネントをカーネルコンポーネントに変換します。 CastKernel オペレータを使用してカーネルコンポーネントに変換するか、次の機能を使用して現在のピクセルのより高いビットコンポーネントに変換します。 CastParallel オペレータ。
実行方法の例については、Working with Kernels のチュートトピックを参照してください。
オペレーターリファレンスの FrameBufferRandomRead およびオペレーターリファレンスの FrameBufferRandomRead (imaFlex) を参照してください。
ボトルネックのトラブルシューティング#
典型的なボトルネックは、 InsertLine オペレーターリファレンスの InsertImage またはオペレーターリファレンスの が次と組み合わされていない場合に発生します PARALLELup。オペレータの順序が好ましくない場合、スループットが低下する可能性があります。
挿入オペレータを使用すると、処理パイプラインにフィードされるデータ量が増加し、全体的な帯域幅が上昇します。したがって、 InsertLine または InsertImage オペレータの後の Parallelism は、結果として生じる帯域幅を処理するのに十分な高さでなければなりません。
例#
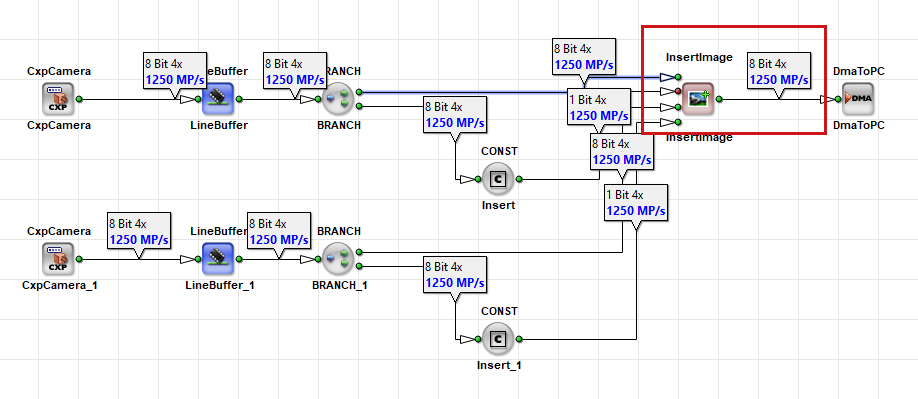
上の画像の例は、 InsertImage オペレータには2つの入力リンクがあることを示しています。各入力リンクは、Parallelism 4 を使用して、1250 MPixel/s の帯域幅で 5120 × 5120 ピクセルの解像度の画像を処理します。
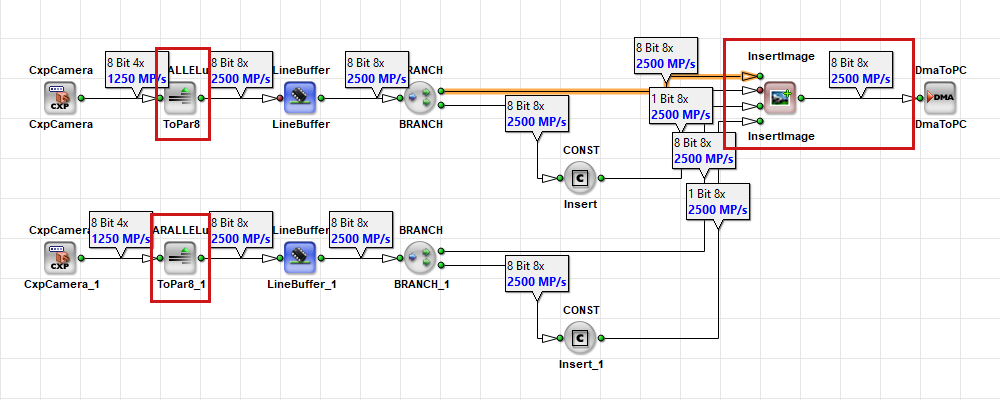
Parallelism が InsertImage オペレータの前に増加されない場合、入力あたりの帯域幅は 1250 MPixel/s のままになります。ただし、入力リンクが2つあるため、デザインは 2 × 1250 MPixel/s の複合スループットを処理する必要があります。
この帯域幅のボトルネックを回避するには、次を使用してParallelismを増やします。 PARALLELup オペレーターを次のように配置します: InsertImage オペレーターを次のように表示します:
関連トピック#
- Pipeline Concept チュートリアル トピック — スループット、ボトルネック、およびリンク容量
- パラメータ設定 チュートリアルトピック —
ParallelismリンクProperty - Memory要素 チュートリアルトピック — RAM データ幅と
LineBufferの変換 - Working with Kernels チュートリアル トピック — カーネルサイズ対 Parallelism
- Latency チュートリアル トピック — Parallelism とレイテンシ
- ユーザーマニュアルの Bandwidth of an Applet — 帯域幅の正式な定義
- Device Resources — ベースデザインクロック周波数
- ユーザーマニュアルの帯域幅のボトルネック — オペレーターの順序とボトルネック