レイテンシー#
主要用語
レイテンシー は、1つのピクセルがカメラ(またはその他のソース)の入力から、次のような出力に至るまでに、生成されたFPGAパイプラインを通過するのに要する時間です。 DmaToPC。その遅延はVisualAppletsエディタではなく、フレームグラバー上で発生します。 帯域幅 は、1秒あたりにリンクを通過できるピクセル数です。
デザインでは高い帯域幅と低いレイテンシーを同時に実現できます。多くのピクセルがFPGAパイプライン内を並列で移動しますが、フレームの最初のピクセルがDMAに渡されるまでには、依然として一定の時間がかかります。
レイテンシと帯域幅#
Bandwidth と latency は、同じパイプラインの異なるPropertyを表します。
| 帯域幅 | レイテンシー | |
|---|---|---|
| 質問 | 1秒あたりに流れるデータ量は? | 1つのピクセルが処理されるまでどれくらい待つか? |
| 依存先 | Parallelism とベース設計クロック | オペレータの種類とアルゴリズム |
| 数式(リンク) | 帯域幅 = Parallelism × Base Design Clock | オペレータごとに定義されています。以下を参照してください。 |
帯域幅とレイテンシーは、同じパイプラインの異なるPropertyを記述します。
設計ガイドライン
VisualAppletsのデザインから生成されたFPGAパイプラインでは、レイテンシーは理論上の最小値に近く維持されます。ほとんどのオペレーターは画像全体を保存せず、情報を利用可能になり次第すぐに結果を転送します。
レイテンシの定義#
レイテンシー はデザイン内のピクセルの遅延であり、ピクセルが処理チェーンに入ってから出るまで(たとえば、 DmaToPCを使用します。
重要なポイント:
- Latencyはオペレーターごとに個別に定義され、主にそのアルゴリズムの実装に依存します。
- モジュールを追加しても、スループットが低下することはありません。生成されたFPGAパイプライン内のすべてのステージは並列で動作します。あるモジュールが1つのピクセルを処理している間、他のモジュールは別のピクセルを処理します。パイプラインがFillされた後は、より長いチェーンであっても、すべてのクロックサイクルで新しいピクセル(またはピクセルパケット)を受け入れることができます。
- オペレーターを追加すると、latencyが増加する可能性があります。単一のピクセルのパス上で各オペレーターが遅延を追加する場合があり、それらの遅延はチェーンに沿って累積されます。Oタイプ・オペレーターによる数クロックサイクルの遅延は、通常、バッファのライン遅延やフレーム遅延に比べてわずかなものです。
- Latencyは、ブロッキングやバッファのFillレベルとは異なります。下流の処理が遅い場合、バッファがFillされ、遅延がさらに増加します。このトピックでは、オペレーター自体に組み込まれているminimum latencyについて説明します。
設計例#
このトピック全体を通して次のデザインが使用されます。これは、1つのバッファと2つの処理ステップを持つ単純な取り込みパスを示しています。
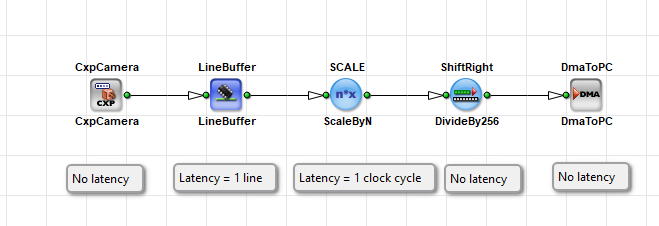
上記のデザインにおけるレイテンシーのアノテーションは、この特定の例に適用されます。
| オペレーター | この例におけるLatency |
|---|---|
CxpCamera | この例では、追加のアルゴリズム的レイテンシーはありません |
LineBuffer | 1ライン |
ScaleByN | 1クロックサイクル |
ShiftRight | 追加のレイテンシーはありません |
DmaToPC | この例では、追加のアルゴリズム的レイテンシーはありません |
このパス上のピクセルの総Latencyは、以下によって左右されます: 1ラインの遅延 のメンバー LineBuffer、および他のオペレーターの小さな処理遅延が加わります。「追加のアルゴリズムレイテンシーなし」という意味は CxpCamera および DmaToPC 、この例ではそれらのオペレーターがその種の余分な遅延を追加しないことを意味します。ピクセルがPC上に即座に現れるという意味ではありません。カメラインターフェースのタイミング、PCIe転送、ホストバッファリング、およびディスプレイはこの表の範囲外です。
設計例におけるピクセルフロー#
サンプルデザインでは、画素がカメラからカメラインターフェイスを介して転送されます LineBufferが無効になります。 LineBuffer データを最初に出力に転送する前に、1フルラインを収集します。
フルラインが LineBufferにより、バッファはそのラインのピクセルを出力します。その 同時に、カメラはすでに 次のラインを転送しています。これが、生成されたFPGAハードウェアのパイプライン動作です。つまり、取り込み、バッファリング、処理、DMAをオーバーラップさせることができます。VisualAppletsはそのパイプラインを記述するものであり、カメラストリームを直接処理するわけではありません。
レイテンシの計算#
Latencyはオペレーターによって異なります。デザイン全体に対して一意の数値はありません。1つのピクセルのパスに沿った遅延を合算(または時間軸で追跡)します。
ラインベースのレイテンシ(バッファオペレータ)#
次のようなBuffer Operatorは、 ImageBuffer および LineBuffer 最低限必要となります: 1フルライン そのラインの最初のピクセルを出力できるようになる前に対象となります。 LineBuffer の場合:
レイテンシー = 1ライン
時間で測定した場合、1ラインのレイテンシーは次のようになります:
ラインレイテンシー = (1ラインあたりの画素数)/(リンクのピクセルレート)
ピクセルレートはParallelismとBase Design Clockに依存します。ライン幅が広い場合やリンクが遅い場合、最初の画素がバッファから出力されるまでの時間が長くなります。
クロックサイクルレイテンシ(処理オペレータ)#
多くの処理オペレーターは、ピクセルを固定数のクロックサイクルだけ遅延させます。パイプラインがFillされた後も、すべてのクロックサイクルで1ピクセル(または並列ピクセルパケット)を受け入れて出力し続けることができます。この場合、単一のピクセルの遅延は、内部レジスタステージによる遅延のみとなります。
サンプルデザインでは、 ScaleByN が追加します:
レイテンシー = 1クロックサイクル
時間で測定した場合、1クロックサイクルのレイテンシーは次のようになります:
サイクルレイテンシー = 1 / Base Design Clock周波数
たとえば、Base Design Clockが312.5 MHzの場合、1クロックサイクルは3.2 nsです。
次のようなOperatorは、 ShiftRight この例では、以下が追加されます: 実用上意味のある遅延ではない 。入力値が利用可能になり次第、結果を転送します。
オペレータの種類とレイテンシ#
VisualAppletsでは、オペレーターがタイプ別にグループ化されています。このタイプにより、レイテンシーを見積もることができます。
| タイプ | アイコンの形状 | 一般的なLatencyの動作 |
|---|---|---|
| Oタイプ | ラウンド | 非常に小さく固定された遅延 — 通常はクロックサイクルの定数です。例: 約 3.2 ns の遅延(312.5 MHzのベースデザインクロックで1サイクル)。 |
| Mタイプ | スクエア | 可変遅延。ラインまたはフレームのバッファリング、画像寸法の変更、または入力のブロックを行うことができます。正確なレイテンシについては、オペレーターのドキュメントを確認してください。 |
| Pタイプ | スクエア | Mタイプに似ていますが、入力の積極的なブロックは行いません。正確なレイテンシについては、オペレーターのドキュメントを確認してください。 |
CxpCamera, LineBufferおよび DmaToPC はMタイプのオペレーターです。 ScaleByN および ShiftRight はOタイプのオペレーターです。 DmaToPC はMタイプですが、この例では大きなアルゴリズム遅延を追加せず、データが到着するとすぐにDMAにデータを渡します。ホストソフトウェアで画像が表示されるまでの時間は、これとは別の、より後段階での遅延となります。
主要用語
Oタイプオペレーターは、固定長の短いパイプセクションのようなものと考えてください。Mタイプオペレーターは、ストレージタンク(バッファ)やより複雑な機構を含む可能性のあるセクションと考えてください。最初の1滴が出てくる前にタンクが満たされる必要があり、これがラインベースのレイテンシーです。これらのパイプやタンクは、VisualAppletsで配置したモジュールから生成される、FPGA上のハードウェアステージです。
Parallelism とレイテンシ#
Parallelism はレイテンシを解消するものではありません。帯域幅を増加させます。1クロックサイクルあたりにより多くのピクセルがリンクを通過します。
例: Parallelism 4 の場合、4つのピクセルが1クロックサイクルでリンクを通過します。 最初のピクセル フレームのデータには、引き続き同じオペレーター遅延(例えば、以下の1ライン分の遅延など)が必要です: ImageBufferの1ライン分のような、同じオペレーター遅延が依然として必要になります。パイプラインが満たされた後、4つの新しいピクセルがすべてのクロックサイクルでオペレーターから出力されるようになります。
- 高 Parallelism → 高スループット(帯域幅)。
- バッファとアルゴリズム → 最初のピクセルのレイテンシ。
両方のプロパティは独立しています。VisualApplets の設計では、生成される FPGA パイプラインにおいて高い帯域幅と最小限のレイテンシの両立を目指しています。
オペレータのレイテンシ値の確認方法#
デザインで使用する予定のオペレーターのレイテンシー値を見つけるには、次の情報源を使用します。
- Operator Reference — 各オペレーターのレイテンシ(または処理遅延)については、Operator Referenceに記載されています。
- 製品内ヘルプ — デザイン内でオペレーターを選択し、ヘルプを開いてパラメータとタイミングの詳細を確認します。これは Operator Reference と同じ内容であり、VisualApplets のツール内ヘルプとして提供されています。
特にMタイプのオペレーターの場合は、必ずドキュメントを確認してください。レイテンシーはパラメータ(フィルターオペレーターのカーネルサイズや、Memoryオペレーターのバッファ深度など)によって異なる場合があります。
ほとんどのオペレーターは画像全体を保存しません。情報が利用可能になり、出力がブロックされていない限り、出力結果を計算します。そのため、生成されたFPGAパイプラインのレイテンシーは、選択したアルゴリズムの理論上の最小値に近づけられています。
例えば、PCがデータを十分に高速に受け取れないために出力がブロックされている場合、バッファの Fill レベルが上昇し、ホストにピクセルが表示されるまでの時間が長くなります。その追加の遅延は固定のオペレーターレイテンシではなく、フロー制御と負荷時のバッファリングに起因するものです。
関連トピック#
- Pipeline Concept チュートリアルのトピック — アンバッファードフローと並行処理
- Parallelism チュートリアルのトピック — Parallelism とレイテンシ
- Operator Types and Synchronization チュートリアルのトピック — オペレーターの種類とレイテンシ
- Memory Elements チュートリアルのトピック — バッファーオペレーターのラインレイテンシ
- Working with Kernels チュートリアルのトピック — カーネルに関連する遅延
- ユーザーマニュアルの Bandwidth of an Applet — 帯域幅とレイテンシの関係
- Operator Reference — 個々のオペレーターのレイテンシ値
- Device Resources — ベースデザインクロック周波数