パイプラインコンセプト#
正式なデータフローモデルについては、ユーザーマニュアルのData Flowを参照してください。デザインのエンドツーエンドの構築と検証方法については、From Empty Design to Running Appletのチュートリアルをご覧ください。
モジュール、リンク、およびパイプラインの構造#
VisualAppletsのデザインは、オペレーターライブラリのoperatorsから構築します。配置された各オペレーターインスタンスはmoduleになります。モジュールにはinputおよびoutputポートがあります。ポート同士はlinksで接続します。図では、各リンクが矢印として示されています。
VisualAppletsデザイン内のモジュールとリンクは、合わせて画像処理のpipelineを形成します。ビルドによって、このグラフがフレームグラバーのFPGA上のハードウェアステージとして実装されます。処理の順序は接続順に従います。分岐と合流により、グラフ内に並列パスと再結合ポイントが定義されます。
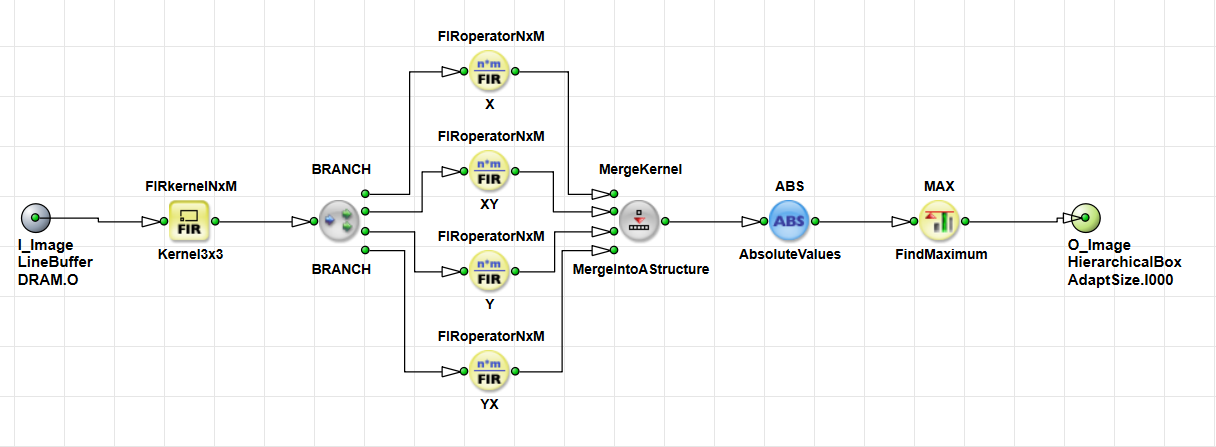
各モジュールは、入力データが利用可能になるとすぐに処理を開始します。計算が完了し、出力がブロックされていない場合、その結果を出力リンクに転送します。実行時には、この動作は VisualApplets 内のグラフィカルシンボルではなく、モジュールから生成された FPGA ロジックによって実装されます。したがって、パイプライン構造によって、データがどこで分岐し、どこで合流し、どのモジュールが直列または Parallel で実行されるかが定義されます。
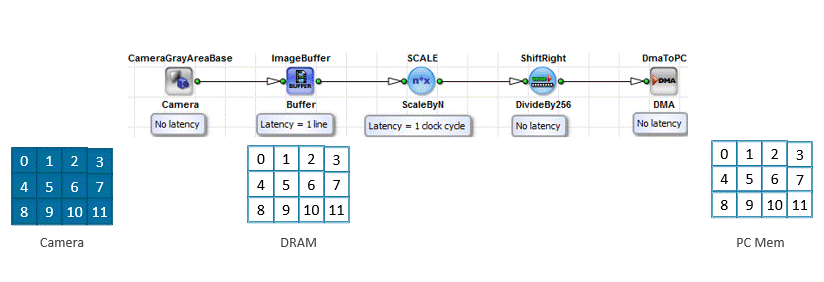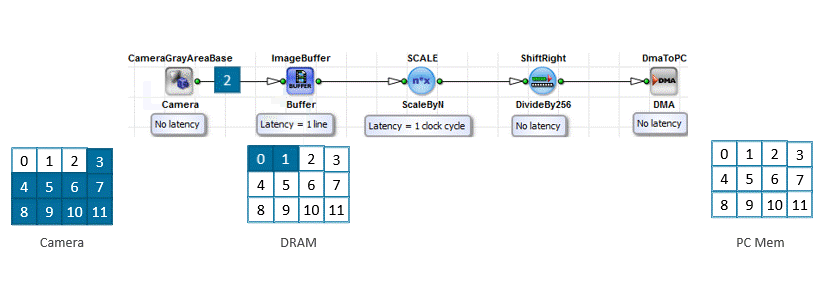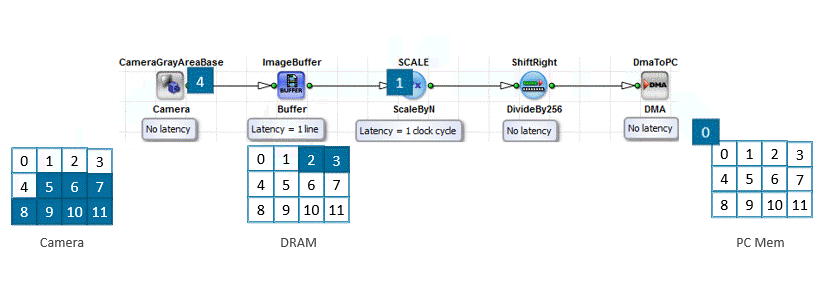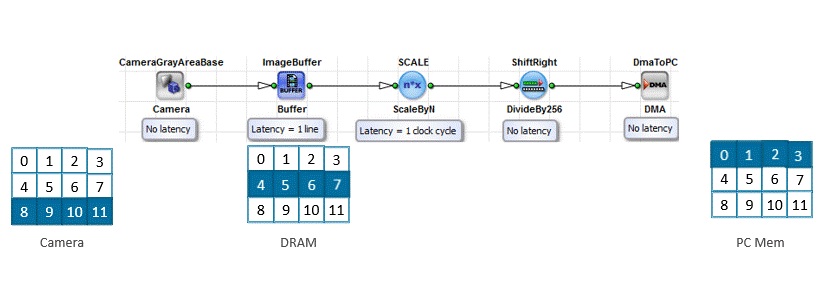
ピクセルは、1つの完全な画像として一度にフレームグラバーに入力されるわけではありません。カメラがone after anotherで画像取得パスに転送するか、アプレット内部の画像ソースがone after anotherで生成します。その後、それらのピクセルは同じシーケンシャルな順序でパイプラインステージを通過します:
主要用語
ピクセルを道路上の車のように考えてみてください。車はパスに沿って互いの後を追って進みます。どの瞬間においても、異なる車(ピクセル)が道路(パイプラインステージ)上の異なる位置にいます。道路自体は、VisualAppletsのデザインで配線したパイプライン構造です。ビルド後のその道路は、VisualAppletsエディタ内のパスではなく、フレームグラバーのFPGA上のハードウェアです。
このたとえにおいて、Parallelismは道路の車線の数に相当します。車線が多いほど、より多くの車(ピクセル)が同時に前進できます。
パイプラインの入力と出力#
すべてのパイプラインには、デザインにデータを供給するsourceが少なくとも1つ、およびFPGAの処理パスから外に出る1つ以上のsinksが存在します。ソースとシンクは通常、M型のオペレーターです。使用可能なオペレーターは、ターゲットのハードウェアプラットフォームによって異なります。
入力#
データがパイプラインに入る方法には、次のようなものがあります。
- カメラまたはその他の画像ソースからの場合:プラットフォーム固有のカメラオペレーターが、接続されたカメラからの連続的なピクセルストリームを画像取得パスに配信します。
- アプレット内部で生成される場合: 次のようなオペレーター
CreateBlankImageまたはCoefficientBufferライブカメラなしで画像データの作成や再生を行います。これらのソースは、Test Patterns、ホストからアップロードされた参照データ、またはカメラから取り込まないデザインに使用します。
信号パスは、デジタル入力(例えば GPI) またはアプレット内部の信号ジェネレーターからの場合。フローコントロール下におけるカメラソースと停止可能なアプレット内部ソースの違いについては、以下を参照してください。 停止可能および停止不可能なデータストリーム チュートトリアルのトピック。
出力#
処理された結果がパイプラインから出力される方法には、次のようなものがあります。
- ホストへのDMA: The
DmaToPCオペレータは、ダイレクトメモリアクセスを使用して画像データをホストPCのMemoryに転送します。これは、ホストソフトウェアで処理済み画像を取得するための通常のパスです。 - GPOを介した信号出力: The
GPOオペレーターはフレームグラバー上のデジタル出力ピンを駆動します。ホストPC外でのトリガー、ステータス、その他のハードウェア制御信号にはこのパスを使用します。 - ホストへのイベント: The
EventToHostおよびEventDataToHostオペレーターはソフトウェアイベントをホストに送信します。ホストアプリケーションはFramegrabber APIを介してこれらを受信し、アプレット内の条件に対応できます。EventToHostは、信号入力の立ち上がりエッジでイベントを発生させ、ペイロードを持ちません。EventDataToHostは、設定可能なデータペイロードとともにイベントを発生させます。 - レジストリ情報のみ: 一部の結果は、読み取り可能な値としてフレームグラバー上に保持されます。次のようなオペレーター:
GetStatusは、ホストソフトウェアが動的パラメータとして読み取る値を保存します。アプリケーションがステータスや測定値のみを必要とする場合、画像ストリームやDMA転送は不要です。
デザインでは、これらの出力をいくつか組み合わせることができます。例えば、1つのブランチで DmaToPC を介して画像を送信し、別のブランチで条件の発生時に GPO ピンをアサートするか、ホストイベントを発生させることができます。
オペレーターの詳細については、オペレーターリファレンスの DmaToPC、オペレーターリファレンスの GPO、オペレーターリファレンスの EventToHost、オペレーターリファレンスの EventDataToHost、およびオペレーターリファレンスの GetStatus を参照してください。
バッファなしのパイプライン処理フロー#
ほとんどのモジュールは、内部に完全な画像を保存しません。出力値を計算し、情報が利用可能になるとすぐに転送します。
すべてのオペレーターが、入力にデータが到着すると同時に結果を出力するわけではありません。 Mタイプ のオペレーターは特に、出力を遅延させることがあります。これらは次のようなバッファオペレーターだけではありません。 LineBuffer または ImageFifo — 多くのフィルターおよび同期オペレーターも M タイプに該当します。レイテンシがどの程度になるかはオペレーターによって異なります。詳細については、以下を参照してください。 オペレータータイプと同期 チュートリアルのトピックおよび レイテンシー チュートトリアルのトピック。
バッファオペレーターは、下流のモジュールが受け入れることができるようになるまでデータを保存します。
このバッファなし(unbuffered)の動作により、レイテンシが低く抑えられます。同じフレームの他のピクセルがまだカメラの入力にある間に、あるピクセルが目的に到達する可能性があります。取り込み、処理、および DMA は時間的にオーバーラップすることができます。
主要用語
生成されたFPGAパイプラインを、分岐やバルブを持つ配管システムのように考えてみてください。スペースが利用可能になるとすぐに、水がパイプを通って流れます。バッファオペレーターは、ドレインが追いつかないときに満たされる小さな貯水池のようなものです。
パスに沿ってどのようにレイテンシが蓄積されるか、および帯域幅とレイテンシの違いについては、Latency チュートリアルのトピックを参照してください。
ハードウェアにおける並行処理#
フレームグラバーの FPGA では、すべてのパイプラインステージが同時に実行されます。これは、命令を主に順番に実行する一般的な CPU プログラムとは異なります。
1つのFPGAモジュールがピクセルを処理している間、他のモジュールはパスのさらに先にある異なるピクセルを処理します。パイプラインが満たされた後、複数のモジュールが同じ画像を同時に処理します。FPGAは、パイプライングラフに一致する構造を持つ専用ハードウェアとしてVisualAppletsデザインを実装します。
主要用語
VisualAppletsデザインから生成されたFPGAハードウェアでは、処理パスはフレームグラバー上の専用ハードウェアロジックとして実装されます。データはコンベア上のアイテムのように、それらのハードウェアステージを移動します。CPUは通常、データの塊全体をロードし、順番にステップを処理します。
構築されたアプレットと編集可能な *.vad 設計の関係の詳細については、VisualApplets Fundamentals チュートリアルのトピックを参照してください。
スループットとボトルネック#
スループットとは、パイプラインを通過する持続的なデータレートのことです。VisualApplets の設計では、生成された FPGA ハードウェアのリンク上の帯域幅密接に関連しています。
デザイン内のモジュール数によってスループットが低下することはありません。生成されたすべてのFPGAステージは、Parallelismで動作させることができます。並列ブランチの数もスループットを低下させません。ブランチによってハードウェアリソースは追加されますが、個々のパス上のデータレートが低下することはありません。次の2つのデザインに示すように、2つの取り込みパスで異なる数のモジュールを使用しながら、同じスループットを実現できます。
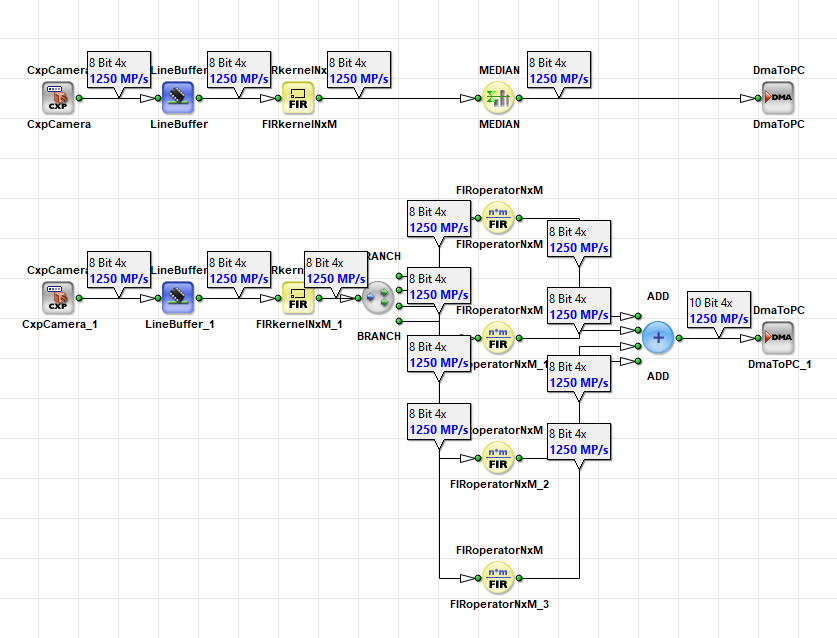
スループットは以下の要因によって決まります。
- Link capacity: モジュール間の接続が伝送できるデータ量。容量は、モジュールとリンクのパラメータ設定、特にParallelism、Bit Width、最大画像寸法によって、Base Design Clockとともに決定されます。リンクプロパティとモジュールパラメータの詳細については、Parameterizationのチュートリアル トピックを参照してください。
- Downstream readiness: モジュールがデータを継続的に受け入れることができるかどうか。バッファがいっぱいであることや後続のモジュールがブロックされていることなどが原因でモジュールがデータを恒久的に受け入れられない場合、フロー制御によってストリームが停止し、ブロッキング、バックプレッシャー、またはその両方が発生します。
- オペレーターの制限:一部のオペレーターは、入力リンクが提供する全帯域幅を処理できません。Operator Reference では、影響を受ける各オペレーターについてこれらの制限を記載しています。
ピクセルレート(秒間ピクセル数)としてのリンクの帯域幅は、次の数式に従います。
帯域幅 = Parallelism × Base Design Clock
このピクセルレートの計算式には、Bit Widthやカーネルサイズは含まれません。Bit Widthが広いほど、またはカーネルが大きいほど、1 クロックあたりのデータ量(ビットまたは値)が増加します。これは DRAM アクセスおよび FPGA リソースにとって重要ですが、このピクセルレートの数値は変更されません。DRAM のデータ幅については、Memory Elements チュートリアルのトピックを参照してください。カーネルとピクセルレートの帯域幅の比較については、Working with Kernels チュートリアルのトピックを参照してください。
ベースデザインクロックは、お使いのフレームグラバープラットフォームによって異なります。Device Resources で値を確認してください。
最大画像寸法もこのピクセルレートの計算式には含まれませんが、パイプラインが処理できる画像サイズを制限するという点で、やはりデザインを形成する重要な要素となります。Parallelism や Bit Width とともに、これらのリンク Property は、カメラやラインスキャンソースと一致している必要があります。
パスのボトルネックは、そのパスに沿った最も低い帯域幅です。設計全体のスループットは、常にこの最も狭いポイントによって制限されます。1 つの狭いリンクまたは帯域幅が制限されたオペレーターにより、同じパス上のそれよりも上流にあるすべての要素のスループットが制限されます。したがって、スループットは、パス上の最も狭い帯域幅と、下流のモジュールがデータを継続的に受け入れるかどうかによって決まります。
設計ガイドライン
Parallelism とリンク Property は、カメラまたはラインスキャンソースに必要なレートをサポートするために必要な大きさにのみ設定してください。これらの値をさらに大きくすると、追加の FPGA リソースが消費されるだけであり、別のコンポーネントがすでにボトルネックとなっている場合はスループットの向上につながりません。
オペレーターによっては、入力と出力の間で Parallelism を変更するものもあります。また、画像を切り抜くなどしてピクセル数を減らすものもあります。その結果、必要な出力帯域幅が入力帯域幅と異なる場合があります。可能な場合、オペレーターは Parallelism を自動的に適応させます。適応できない場合、VisualApplets は Design Rules Check エラーを報告します。
Parallelism の計算および調整に関する情報(設計に必要な帯域幅を計算する方法や、オペレーターがストリームをマージするときに帯域幅のボトルネックをトラブルシューティングする方法の例など)については、Parallelism チュートリアルのトピックおよび Troubleshooting Bottlenecks チュートリアルのトピックを参照してください。
デザインにおけるスループットの視覚化#
Link Info および Throughput フラグを使用すると、デザイン内の平行度とデータスループットを表示させることができます。ツールバーから次のボタンを使用してこれらのフラグを有効にします。
その結果、デザインに Link Info および Throughput フラグが表示されます。
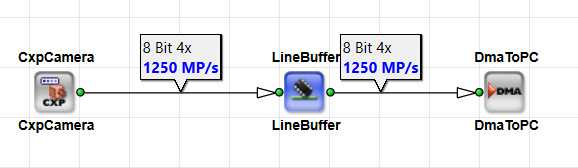
パス上の値を比較して、最も狭いリンクを見つけます。さらに下流にあるオペレータが処理に追いつかない場合を除き、そのリンクがそのパスのボトルネックとなります。
情報
Throughput フラグには、すべてのパフォーマンスの制限が表示されるわけではありません。たとえば、複数の DRAM オペレーターが同じメモリインターフェイスを共有している場合、Shared Memory による結果の DRAM 帯域幅の制限は、スループット表示に反映されません。その他の DRAM の非効率性、ならびにブロッキングおよび潜在的なデッドロックも表示されません。Shared Memory の使用法と DRAM 帯域幅の計画に関するガイダンスについては、Memory Elements チュートリアルのトピックを参照してください。デッドロックの詳細については、Operator Types and Synchronization チュートリアルのトピックを参照してください。
リンクのPropertyと画像フォーマット#
スループットとデータフォーマットは、リンクプロパティとモジュールパラメータに依存します。前述の容量関連のプロパティ(Parallelism、Bit Width、最大画像寸法)のほか、その他の一般的なプロパティには、イメージプロトコルやColor Formatなどがあります。
リンクプロパティはパイプライン全体に伝播します。多くのプロパティは、カメラの出力リンクまたは初期の処理ステージで設定します。これらは、オペレーターによって変更されるまで、すべての下流のリンクに適用されます。モジュールパラメータは、接続されたリンク上のリンクプロパティと一致している必要があります。したがって、上流のリンクでの変更は、別のオペレーターがプロパティをリセットするまで、後続のすべてのオペレーターに影響を与えます。
リンクの Property と伝播規則の全リストについては、ユーザーマニュアルのParameterizationチュートリアルのトピックおよびRules of Linksを参照してください。
image protocolは、リンク上のデータストリームの構造を定義します。VisualAppletsは、さまざまなデータ型 / ストリームフォーマットをサポートしています。
| Protocol | 一般的な用途 |
|---|---|
VALT_IMAGE2D | エリアセンサカメラなどからの、行端およびフレーム端のマーカーを持つ2次元画像。フレーム内の行は異なる長さを持つことができます。 |
VALT_LINE1D | 例えばラインスキャンカメラから得られるような、無限または連続したラインデータ。 |
VALT_PIXEL0D | 画像次元情報を持たない、構造化されていない連続ピクセルストリーム。 |
VALT_SIGNAL | 例えばトリガーロジックなど、すべてのクロックサイクルで有効なシングルビット信号。 |
ピクセルはスキャン順序に従ってパイプラインを移動します。つまり、1行内では左から右へ、フレーム内では上から下へと移動します。一部のカメラソースでは異なる順序が使用される場合があります。ソースがこの規則に一致しない場合は、適切なオペレータを使用して順序を修正してください。
image protocolとピクセル順序の詳細については、ユーザーマニュアルのImage Protocols, Image Dimensions and Data Structureを参照してください。
フロー制御下でソースが一時停止できるかどうかは、パイプラインの配線方法に影響します。カメラオペレーターはnon-stoppableなソースです。通常、その直後にバッファーオペレーターを配置します。詳細については、以下のFlow Control, Blocking, and BackpressureおよびStoppable and Non-Stoppable Data Streamsチュートリアルのトピックを参照してください。
フローコントロール、ブロッキング、およびバックプレッシャー#
生成されたFPGAパイプラインは、ステージ間でflow controlを適用します。ステージがこれ以上のデータを受け入れる準備ができていない場合、ステージは入力をブロックできます。つまり、上位ステージからのデータ要求を停止し、上位ステージがそれに応じて出力を停止します。そのブロッキングは、backpressureとしてパイプラインを逆方向に伝播します。Mタイプオペレーターのみが入力のブロックを行えることに注意してください。VisualAppletsのグラフィカルモジュールはこのハードウェア動作を表すものであり、モジュール自体がフロー制御を適用するわけではありません。
仮に DmaToPC ホストコンピュータへのデータ転送が十分に高速に行えないとします。モジュールは随時その入力をブロックします。ブロッキング信号は上流に向かってバッファオペレータまで伝播します。バッファは、ブロッキングが有効な間、データの転送を停止します。バッファは到着したピクセルを格納し、そのFillレベルが上昇します。カメラがデータの送信を停止すると、バッファは再び空になります。
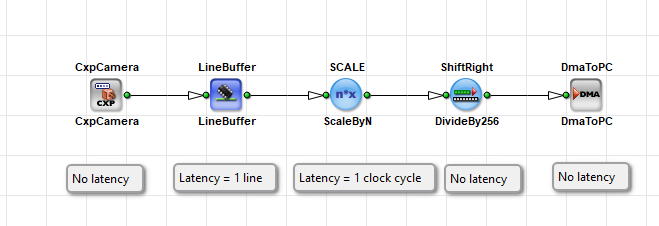
バッファオペレータは、異なるレートで処理を行うステージ間を分離します。停止不可能なカメラソースの後にバッファがない場合、下流のモジュールによるブロッキングによってカメラストリームを減速させることができません。その結果、デザインがDesign Rules Checkに失敗するか、ハードウェア上でデッドロックを引き起こす可能性があります。
オペレーターの種類や、Oタイプ、Mタイプ、Pタイプモジュールにおけるブロッキングの動作については、Operator Types and Synchronizationチュートリアルのトピックを参照してください。
主要用語
Blockingとは、生成されたFPGAステージがそれ以降の入力データを受け入れられない状態(後続ステージがデータを受け入れないため、またはステージ内の処理により多くの時間がかかるためなど)を指します。VisualAppletsのモジュールアイコンはそのステージを表しますが、アイコン自体が待機したりブロックしたりすることはありません。
Backpressureはその背後にあるメカニズムであり、「圧力」が逆方向に作用します。あるステージがデータを十分に素早く処理して受け取らない場合、上位ステージは待機せざるを得なくなり、フローがブロックされます。実際には、下流ステージがデータを受け入れられない(バッファーがいっぱいであるためなど)ため、上流ステージが待機することになります。
このトピックにおけるBandwidthとは、接続のピクセルレート、つまり1秒間にいくつのピクセルがリンクを通過できるかを指します。Bit widthやカーネルサイズによって各ピクセルが搬送するデータ量が変化しますが、これは別の量です。Parallelismチュートリアルのトピックを参照してください。
関連トピック#
- ユーザーマニュアルのData Flow — 正式なパイプラインデータフローモデル
- VisualApplets Fundamentalsチュートリアルのトピック — デザインとハードウェアアプレットの比較
- From Empty Design to Running Appletチュートリアルのトピック — デザイン、DRC、シミュレーション、ビルド
- Parallelismチュートリアルのトピック — 帯域幅とParallelism
- Latencyチュートリアルのトピック — パイプラインに沿った遅延
- Parameterizationチュートリアルのトピック — リンク Property と画像フォーマット
- Stoppable and Non-Stoppable Data Streamsチュートリアルのトピック — フロー制御とカメラソース
- オペレータの種類と同期 チュートリアルのトピック — オペレータの種類とブロッキング
- オペレーターリファレンス